Experten-geshardete Schwarm-Inferenz: das Design
86 % eines 122B-MoE sind 12.544 unabhängige 5.3-MB-Experten. Schneide das Modell an diesem Korn, und ein Smartphone trägt einen echten Anteil der Frontier-Inferenz.
Die These: 86 % des Gewichts von Qwen3.5-122B sind 12.544 wechselseitig unabhängige 5.3-MB-Experten. Sharde am Expertenkorn, und ein schwaches Gerät trägt „8–64 Experten (42–340 MB)" statt „eine 1.4-GB-Layer" — genau die Einheit, die ein Smartphone wirklich halten kann. MoE ist das natürliche Substrat eines Schwarms.
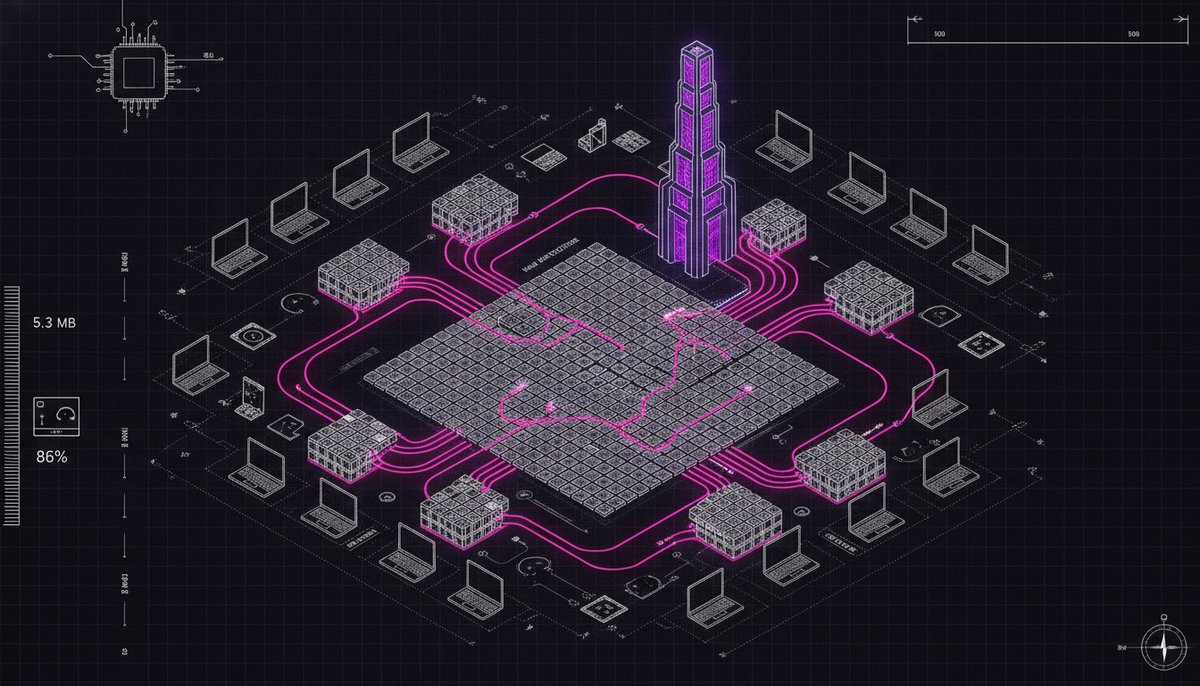
Die Gewichte sind bereits in schwarmgroße Einheiten verpackt
Der Expertenindex ist die äußerste Dimension jedes MoE-Tensors, jeder Experte also eine zusammenhängende, quantblock-ausgerichtete Platte. Ein experten-geschnittenes mini-GGUF ist eine saubere Byte-Range-Kopie — keine Dequantisierung, kein Umpacken.
Backbone-Stage × Experten-Worker
- Backbone-Stage (starker Knoten): Attention + KV-Cache, alle Norms, der Router, der geteilte Experte und das Residual-Combine — der gesamte dichte Pfad. Er hält zudem alle Experten als Fallback-Replik resident (RAM-Offload), was dem Schwarm Churn-Toleranz gibt.
- Experten-Worker (ein Smartphone): kein Transformer. Keine Attention, kein KV, kein Sampler — eine reine Funktion
(hidden, local_ids) → outaus drei Mat-Muls, die nur die eigene Expertenscheibe hält. Passt in jedes Budget, bis hinunter zum 4-GB-Smartphone.
Die Schnittstelle: Der Router läuft einmal auf dem Backbone, mit Autorität.
cur   = ffn_norm(x)                       # backbone
ids,p = top_k(softmax(cur @ router), 8)   # backbone — authoritative
── dispatch selected experts to owner nodes ──
send  (cur rows, local_ids)  →  worker    # ~6 KB per decode step
recv  expert_out             ←  worker
x = x + combine(p, partials) + shared(cur)  # backbone — numerically exact
Weil der Router genau einmal auf dem Backbone läuft, wird jeder ausgewählte Experte genau einmal von dem Knoten berechnet, der ihn besitzt. Es gibt keine Näherung — das Sharding verschiebt nur, wo die Mat-Muls stattfinden.
Der Schwarm ist der bewährte Belohnungsmarkt, nur feiner gekörnt
Kvasir betreibt bereits einen autonomen Knappheitsmarkt für Layer-Shards, verifiziert auf echten Geräten: Ein Smartphone hinter NAT pollt die Nachfragekarte, schreibt sich in das bestbelohnte Segment ein, lädt nur dieses Fenster partiell herunter, lädt es auf seine Adreno-GPU und vollendet die Ring-Inferenz — und verdient Beitragsbelohnungen. Das Experten-Sharding nutzt all das wieder — Abdeckungskarte, Selbsteinschreibung nach Maximalbelohnung, Teil-Download, Belohnungen je Knoten — und ändert nur die Abdeckungseinheit von *Layer-Bereichen* zu *(Layer, Experten-Bereich)*.
Teilgewicht-Teilnahme + das 443-Relay
- Belohnungsgetriebener Teilgewicht-Download: Konventionelle RPC/TP/PP-Aufbauten schicken den vollen Checkpoint an jeden Rang, und ein Scheduler diktiert die Platzierung. Bei Kvasir lädt ein Knoten nur die Scheibe, die er berechnen wird, und wählt diese Scheibe selbst, nach Belohnung — ein 254-MB-Stage-mini-GGUF gegenüber dem 77.6-GB-Vollmodell. So tritt ein 4-GB-Smartphone einem Modell bei, das weit größer ist als es selbst.
- 443-Relay-Datenebene: Cloudflares 80/443-only-Edge plus Carrier-NAT verhindern das direkte Anwählen in beide Richtungen. Eine WebSocket-Brücke pro Edge mit 1-Byte-Rollen-Preamble lässt beide Seiten ausgehend wählen (das Smartphone öffnet null eingehende Ports). Die Landung erforderte drei echte Bugfixes — Build-Fingerprint-Abgleich, Node-Token-Download-Auth und ein Kotlin-
Int.ushr-Framelängen-Bug, der jeden Frame ≥ 64 KiB still beschädigte (ushrnutzt nur die unteren 5 Bits des Shifts;len ushr 56wurde zulen ushr 24) — behoben durchLong-Shifts.
Ein Durchsatzgewebe, kein Niedriglatenz-Decoder
Dekodieren sind 49 serielle Layer, und ein Internet-Roundtrip pro Layer kostet 2.5–10 s pro Token. Der Wettkampf des Schwarms ist also, Modelle zu servieren, die niemand allein hosten kann, gemessen am Gesamtdurchsatz: Batch-Dispatch amortisiert das RTT, das Backbone hält einen Hot-Expert-Cache, und Anfragen werden zu nahen Repliken geroutet. Der Niedriglatenz-Pfad bleibt beim Pipeline-Ring.
M0 → M4
- M0 — Backbone-Experten-RAM-Offload: 122B auf einem Koordinator, ohne Graph-Chirurgie.
- M1 — Expert-Parallel-Beweis auf einem Host: experten-geschnittenes mini-GGUF + Worker-Runtime + Dispatch, Logits exakt gleich dem Monolithen.
- M2 — LAN- + NAT-Smartphone-Worker berechnen echte 122B-Experten durch das 443-Relay.
- M3 — Abdeckungsmarkt am Expertenkorn mit Repliken und Churn-Fallback.
- M4 — Durchsatz: Batch-Dispatch + Hot-Expert-Cache, tokens/s skalierend mit der Worker-Zahl.