Phase 2 — Im Inneren eines 122B-MoE: Warum die Gewichte geshardet werden wollen
Eine Analyse von Qwen3.5-122B auf Tensorebene: 86 % der Bytes sind 12.544 unabhängige Expertenplatten, jede nur eine saubere Byte-Range-Kopie von der Eigenständigkeit entfernt.
Bevor wir irgendetwas entwarfen, nahmen wir den 122B auf der Platte auseinander. Die Frage: Wenn ein Schwarm schwacher Geräte dieses Modell tragen soll, was ist die natürliche Trageeinheit? Die Antwort fiel aus dem GGUF-Tensorlayout selbst heraus.
Woraus eine MoE-Layer wirklich besteht
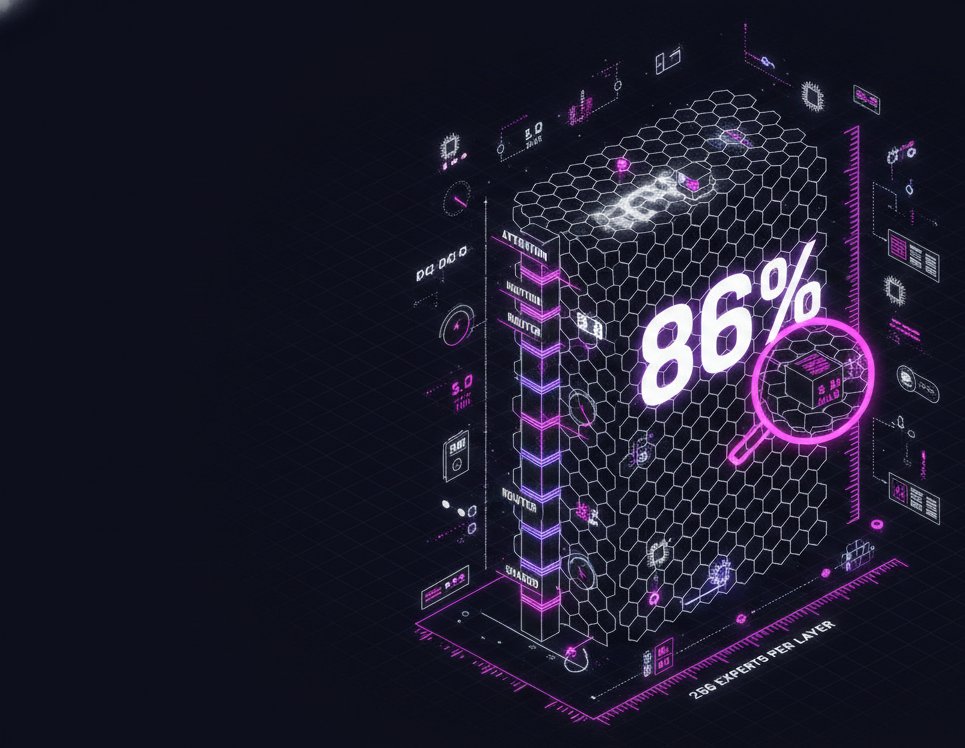
Jede Layer teilt sich in einen dichten Pfad — Attention + KV, die Norms, der Router (ffn_gate_inp), ein geteilter Experte — und eine Expertenbank: 256 unabhängige FFNs, gespeichert als drei gestapelte Tensoren (ffn_up_exps, ffn_gate_exps, ffn_down_exps). Der dichte Pfad ist die Minderheit der Bytes; die Expertenbank sind 86 % des Modells.
Experten sind zusammenhängende, blockausgerichtete Platten
- Der Expertenindex ist die äußerste ggml-Dimension (
ne[2]) jedes Expertentensors — Experte *e* belegt eine zusammenhängende, quantblock-ausgerichtete Platte roher quantisierter Bytes. - Das macht die Extraktion je Experte zu einer Byte-Range-Kopie:
data[a:b], keine Dequantisierung, kein Umpacken — ein experten-geschnittenes mini-GGUF ist billig zu erzeugen und bittreu. - Pro Token feuern je Layer nur 8 von 256 Experten, vom Router gewählt — der Expertenverkehr einer Layer beim Dekodieren ist eine Handvoll kleiner Matrixmultiplikationen über einen Hidden-Vektor.
Die Trageeinheit fällt von 1.4 GB auf 5.3 MB
Am Layer-Korn ist das Minimum, das ein Knoten halten kann, ~1.4 GB — für die meisten Smartphones unerreichbar, sobald App, KV und OS ihren Anteil nehmen. Am Experten-Korn ist die Einheit 5.3 MB, und ein realistischer Beitrag sind 8–64 Experten (42–340 MB) — bequem in jedem modernen Gerät. Die Experten sind wechselseitig unabhängig, Eigentum kann also beliebig verstreut und frei umverteilt werden. Diese Analyse machte das Sharding auf Expertenebene zur Design-Wette: Die Gewichte waren bereits in schwarmgroße Einheiten verpackt — das Netzwerk musste die Verpackung nur ehren.