Phase 0 — Die Engine: linkcpp, eine Steuerungsebene für Inferenz-Engine
Inferenz-Engine liefert eine fähige RPC-Datenebene, aber keine Steuerungsebene. linkcpp ergänzt die fehlende Hälfte — Discovery, Planung, Start und Gateways — um nah am Upstream gebaute Binaries.
Alles, worauf Kvasir läuft, beginnt hier. linkcpp ist eine Steuerungsebene mit verfügbarem Quellcode (Business Source License) um die RPC-Datenebene der Inferenz-Engine: Sie führt große KI-Modelle über mehrere GPUs und Maschinen mit nah am Upstream gebauten ggml-rpc-server- / llama-server-Binaries aus. Die Datenebene trägt nur ein kleines Patch-Set — alles andere, was linkcpp hinzufügt, ist Orchestrierung.
Eine Datenebene ohne Steuerungsebene
Inferenz-Engine kann ein Modell bereits per RPC über Maschinen verteilen — aber jemand muss die GPUs entdecken, entscheiden, welche Layer wohin gehen, die richtigen Worker mit den richtigen Budgets starten, prüfen, dass jeder Knoten dasselbe Protokoll spricht, und eine API bereitstellen, die Entwickler wirklich aufrufen können. Für einen Cluster ist das von Hand lästig; für ein offenes Netzwerk fremder Geräte unmöglich. Diese Koordinationsschicht ist linkcpp.
Ein Hub, Upstream-basierte Worker, Standard-Gateways
Anfragefluss — der Hub orchestriert, Upstream-basierte Binaries rechnen.
browser / SDK
  → hub :19000                      # FastAPI control plane (single Docker image)
  → GPU-less llama-server master    # per-controller, :8080+
  → ggml-rpc-server workers         # local slots, remote units, managed agents
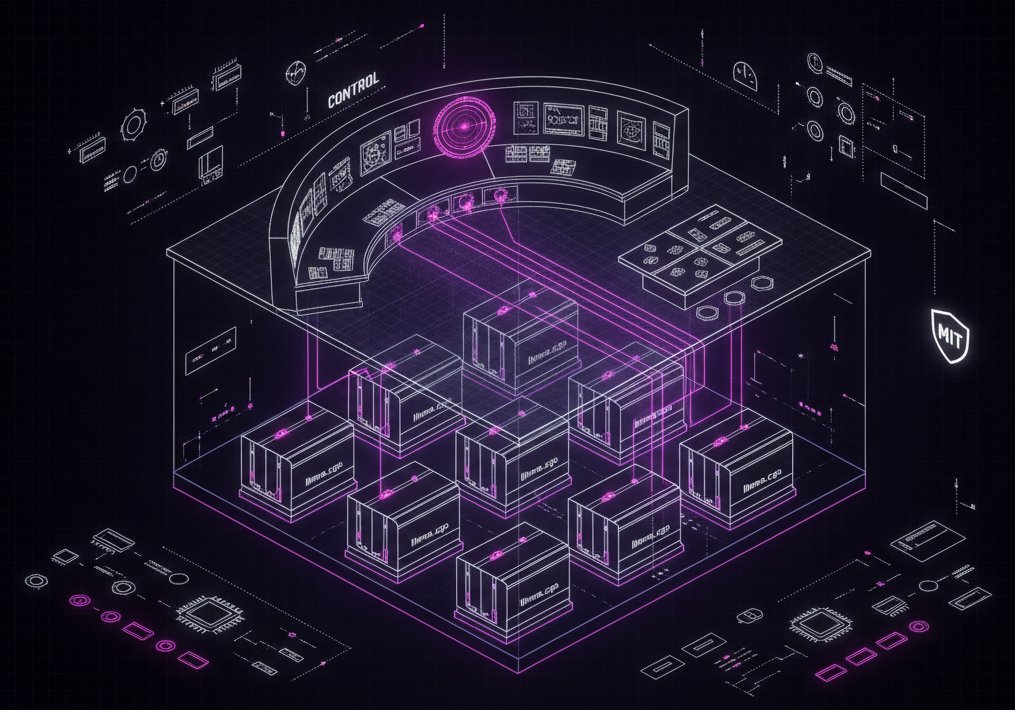
- Drei Beitrittswege: feste lokale Node-Slots mit editierbaren VRAM/RAM/CPU-Budgets; Remote-Units — einen anderen Hub registrieren und dessen Knoten importieren; und verwaltete Node-Agents — reine Worker-Dienste über schlichtes Request/Response-HTTP, bewusst ohne persistenten Stream, damit sie einfache LAN/VPN-Routings überleben.
- Kompatibilitäts-Gating ist erstklassig: Jede Unit, jeder Knoten und Agent meldet eine Protokoll-/Runtime-Pack-Identität plus Backend-Details. Abweichungen bei Unit, Runtime-Pack, Inferenz-Engine-Revision und RPC-ABI werden vor bind, plan, load oder infer hart blockiert — Backend-Unterschiede (CUDA/Metal/Vulkan/CPU) werden als Fähigkeiten geführt, nicht als Ablehnungen.
- Der Planner liest GGUF-Metadaten und erzeugt zusammenhängende Layer-Platzierung je Knoten,
--tensor-split, KV-Cache/Layer/Experten-VRAM-Schätzungen und optionales Experten-FFN-Offload in RAM. - Gateways: Jeder Controller exponiert OpenAI-kompatible (
/v1/chat/completions,/v1/models) und Anthropic-kompatible (/anthropic/v1/messages|models) Endpoints, getragen vom selben geladenen Modell — bestehende Clients funktionieren unverändert.
Diese bewusste Trennung — eine nah am Upstream gehaltene Datenebene unter einer Steuerungsebene mit verfügbarem Quellcode — ist das Fundament für alles Spätere: Ring-Runtime, Layer-Markt und schließlich der Experten-Schwarm sind allesamt Steuerungsebenen-Evolutionen über derselben Rechenleistung.