Phase 5 — Verteilter Experten-Dispatch (M2)
Eine Live-122B-Dekodierung übergibt die Expertenrechnung einer Layer per TCP an einen separaten Worker-Prozess — und sagt exakt denselben Token voraus.
Backbone-Dekodierung → TCP → Worker → Experten → derselbe Token
Der Experten-Worker serviert die Layer-0-Scheibe als separaten Prozess (ROCm), und der build_moe_ffn-Dispatch-Callback des 122B-Backbones verschickt (cur, sel) über TCP und empfängt die Expertenausgaben. Der Logit-Cosine ist exakt der In-Process-Wert (0.99868775) — der Transport ist verlustfrei. Expert-paralleles Schwarmrechnen funktioniert über eine Prozessgrenze hinweg.
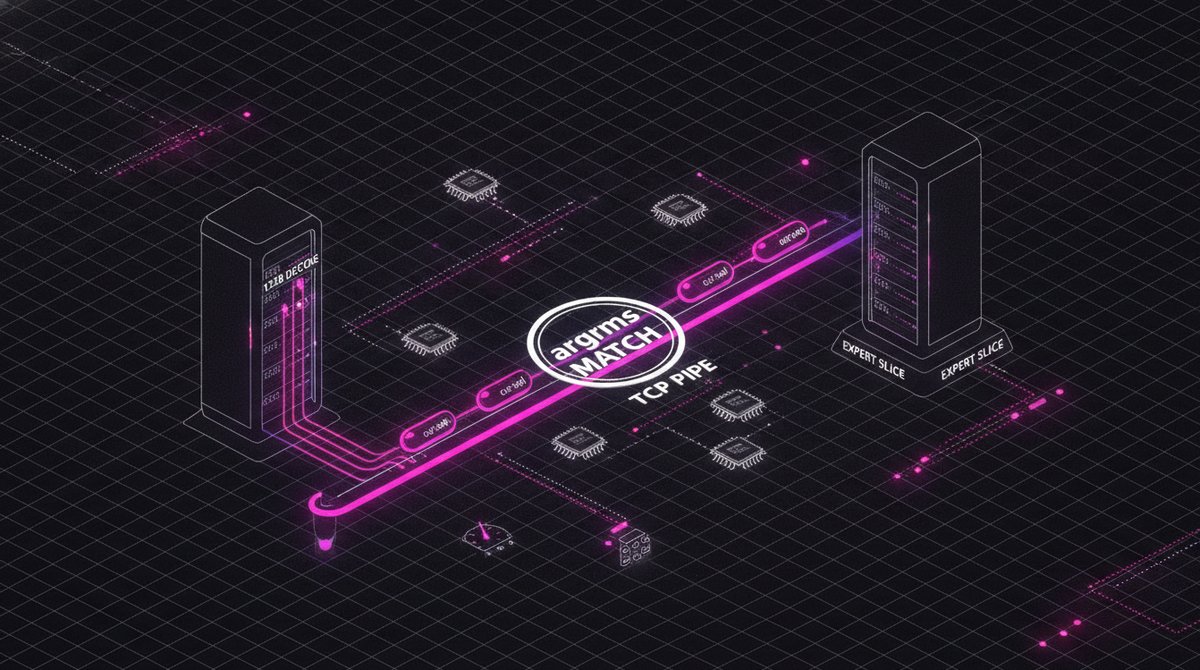
Eine langlebige TCP-Verbindung — derselbe Stream, den Ring/443-Relay tunneln können.
# worker: serving as a separate process
linkcpp-expert-worker --serve 52700 --model L0_all.gguf --layer 0 --n-embd 3072
# backbone: build_moe_ffn callback dispatches to the worker
linkcpp-moe-verify 122B.gguf ... --dispatch-port 52700
  → protocol: [n_used, n_tokens] + cur + sel  →  experts
Die verteilte Dispatch-Pipeline
--serve-Modus: Scheibe laden, auf TCP lauschen,(n_used, n_tokens, cur, sel) → expertsbeantworten.--dispatch-port: der Backbone-Callback sendet/empfängt per TCP an einen separaten Worker und ersetzt die In-Process-Rechnung.- Gemessen auf einer Live-122B-Dekodierung mit Layer-0 außerprozesslich dispatcht → argmax MATCH, cosine 0.99869 (= in-process, verlustfrei).
- M2-Kern (früher): das ARM des Smartphones berechnete echte 122B-Experten bei cosine 0.99992 (Android-Crossbuild).
Als Nächstes: denselben TCP-Stream durch das 443-Relay zu Workern auf anderen Maschinen und Smartphones tunneln (der Transport wurde bereits in der Ring-Arbeit bewiesen), dann der M3-Abdeckungsmarkt und M4-Batch-Durchsatz.