Phase 6 — Der Experten-Abdeckungsmarkt (M3)
Schwache Knoten sehen, welcher (Layer, Experten-Bereich) am knappsten und bestbezahlt ist, und füllen ihn selbst — der bewährte Layer-Markt, feiner gekörnt.
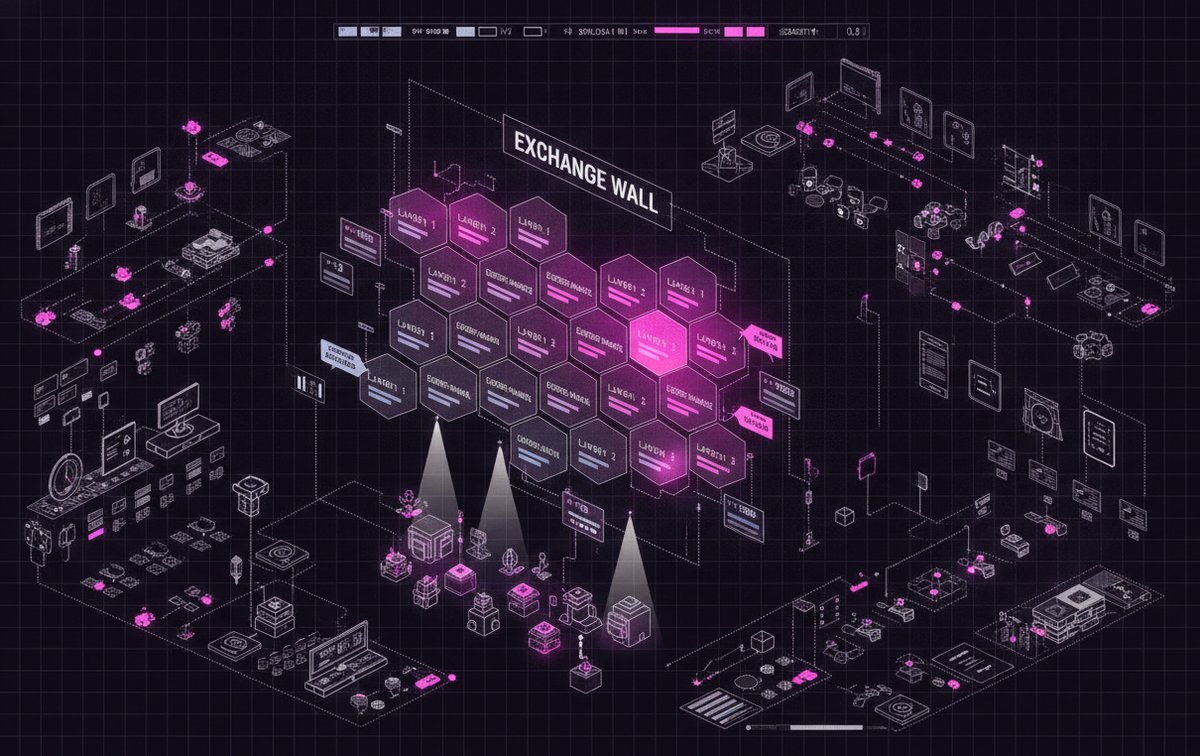
Kvasirs Layer-Shard-Markt — Nachfragekarte, Selbsteinschreibung nach Maximalbelohnung, Teil-Download, Belohnungen je Knoten — war bereits geräteverifiziert. M3 parametrisiert denselben Mechanismus am Korn der (Layer, Experten-Bereich) neu, sodass sich die Abdeckung selbst zu den am stärksten unterreplizierten, bestbezahlten Expertenbereichen hin heilt.
Knappheitsaggregation → Zuteilung des bestbelohnten Bereichs
Drei Worker registrieren sich auf Layer 0: A = [0,128), B = [128,256), C = [0,128) als zweite Replik, mit target_replicas = 2:
| Layer | Experten | Repliken | Knappheit |
|---|---|---|---|
| 0 | [0, 128) | 2 | 0.0 (Ziel erreicht) |
| 0 | [128, 256) | 1 | 0.5 (unter Ziel) |
volunteer(max_experts=64) → schneidet den knappsten Bereich aufs Budget des Knotens zu.
POST /api/expert-volunteer {"max_experts": 64}
→ {layer: 0, experts: [128, 192], scarcity: 0.5, replicas: 1, target: 2}Ein Angebots-/Nachfragemarkt am Expertenkorn
POST /api/expert-coverage— Worker heartbeaten ihre (Layer, Experten-Bereich)-Bestände.GET /api/expert-demand— Replik-Aggregation je Experte → zusammenhängende Expertenbereichs-Segmente mit Knappheitswerten.POST /api/expert-volunteer— teilt den knappsten Bereich zu, zugeschnitten aufs Budget des Knotens.- Der bestehende Layer-Markt (Selbsteinschreibung · Teil-Download · Belohnungen) neu parametrisiert auf (Layer, Experten-Bereich).
Was in M4 folgt: Batch-Dispatch für nebenläufige Anfragen plus ein Hot-Expert-Cache — tokens/s proportional zur Worker-Zahl — und Replik-Routing (nächster/schnellster Worker) mit Churn-Fallback.