Phase 7 — Batch-Dispatch-Durchsatz (M4)
Der Schwarm ist ein Durchsatzgewebe, kein Latenzspiel: Dispatch-Aufrufe zu bündeln amortisiert den Overhead pro Anfrage 77× pro Token.
Größere Batches, mehr tok/s pro Worker
| Batch | tok/s pro Worker |
|---|---|
| 1 | 688 |
| 16 | 4,255 |
| 64 | 8,130 |
| 256 | 30,666 |
| 512 | 53,067 |
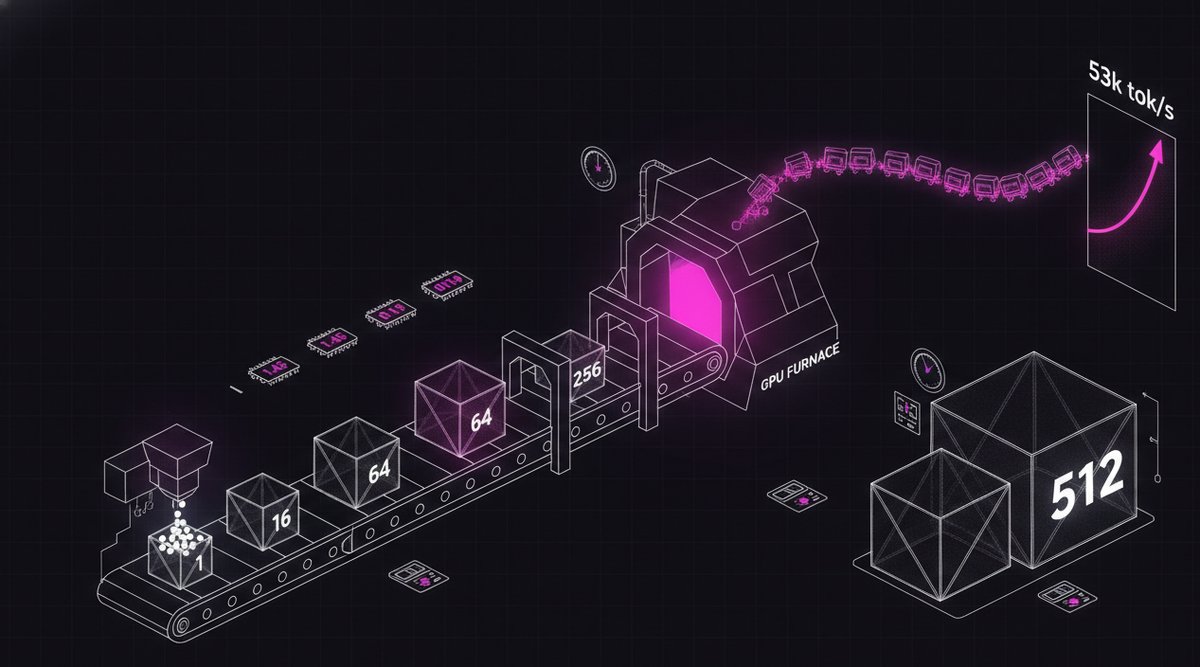
Von 1.45 ms/tok bei Batch 1 zu 0.019 ms/tok bei Batch 512 — eine 77×-Verbesserung pro Token. Die Zeit pro Aufruf bewegt sich kaum (1.45 → 9.6 ms), während der Batch um 512× wächst — die GPU verarbeitet den Batch hinter einem fixen Overhead nahezu gratis. Das ist die Durchsatzgewebe-Eigenschaft, die Expert-Parallel praktikabel macht: Batch-Dispatch amortisiert RTT und Overhead pro Anfrage.
Batch-Dispatch-Durchsatz
- Worker
--bench: compute_dispatch-Zeitmessungen für Batch 1…512 → tok/s. - 53k tok/s pro Worker bei Batch 512 (ROCm) — das Bündeln amortisiert den Overhead.
- Darauf stapeln sich Hot-Expert-Caching und Multi-Worker-Aggregatskalierung (Replik-Routing).
Mit M4 ist die gesamte M0 → M4-Pipeline auf einem echten 122B demonstriert: Backbone-Offload · Expertenscheiben · verifizierte Worker · Live-Decode-Dispatch (argmax MATCH) · verteilte Prozesse · Abdeckungsmarkt · Batch-Durchsatz.