Inferencia en enjambre con sharding de expertos: el diseño
El 86% de un MoE de 122B son 12.544 expertos independientes de 5.3 MB. Corta el modelo a ese grano y un teléfono puede cargar una parte real de la inferencia de frontera.
La tesis: el 86% del peso de Qwen3.5-122B son 12.544 expertos mutuamente independientes de 5.3 MB. Fragmenta al grano del experto y un dispositivo débil carga "8–64 expertos (42–340 MB)" en vez de "una capa de 1.4 GB" — exactamente la unidad que un teléfono puede sostener de verdad. El MoE es el sustrato natural de un enjambre.
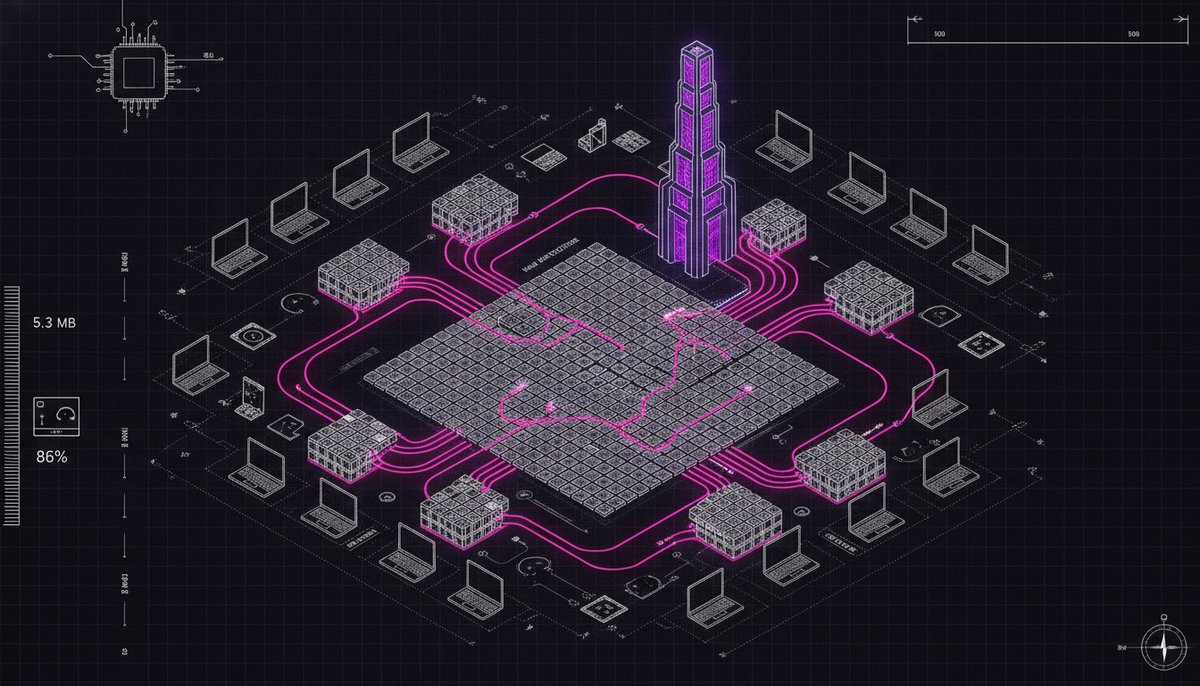
Los pesos ya vienen empaquetados en unidades del tamaño del enjambre
El índice de experto es la dimensión más externa de cada tensor MoE, así que cada experto es una losa contigua alineada a bloques de cuantización. Un mini-GGUF cortado por expertos es una copia limpia de rango de bytes — sin decuantización, sin re-empaquetado.
Stage de backbone × worker de expertos
- Stage de backbone (nodo fuerte): atención + caché KV, todas las norms, el router, el experto compartido y el combine residual — toda la ruta densa. Además mantiene todos los expertos residentes como réplica de respaldo (offload a RAM), lo que da al enjambre tolerancia al churn.
- Worker de expertos (un teléfono): no es un transformer. Sin atención, sin KV, sin sampler — una función pura
(hidden, local_ids) → outhecha de tres mat-muls, que solo aloja su propia rebanada de expertos. Cabe en cualquier presupuesto, hasta un teléfono de 4 GB.
El punto de corte: el router corre una vez en el backbone, con autoridad.
cur   = ffn_norm(x)                       # backbone
ids,p = top_k(softmax(cur @ router), 8)   # backbone — authoritative
── dispatch selected experts to owner nodes ──
send  (cur rows, local_ids)  →  worker    # ~6 KB per decode step
recv  expert_out             ←  worker
x = x + combine(p, partials) + shared(cur)  # backbone — numerically exact
Como el router corre exactamente una vez en el backbone, cada experto seleccionado lo computa exactamente una vez el nodo que lo posee. No hay aproximación — el sharding solo mueve dónde ocurren los mat-muls.
El enjambre es el mercado de recompensas probado, a grano más fino
Kvasir ya opera un mercado autónomo de escasez para shards de capas, verificado en dispositivos reales: un teléfono tras NAT consulta el mapa de demanda, se auto-inscribe en el segmento de mayor recompensa, descarga parcialmente solo esa ventana, la carga en su GPU Adreno y completa la inferencia en anillo — ganando recompensas de contribución. El sharding de expertos lo reutiliza todo — mapa de cobertura, auto-inscripción por máxima recompensa, descarga parcial, recompensas por nodo — cambiando solo la unidad de cobertura de *rangos de capas* a *(capa, rango de expertos)*.
Participación con pesos parciales + el relay 443
- Descarga parcial de pesos guiada por recompensa: los montajes RPC/TP/PP convencionales envían el checkpoint completo a cada rank y un scheduler dicta la colocación. En Kvasir un nodo descarga solo la rebanada que va a computar, y elige esa rebanada él mismo, por recompensa — un mini-GGUF de stage de 254 MB frente al modelo completo de 77.6 GB. Así es como un teléfono de 4 GB se une a un modelo mucho más grande que él.
- Plano de datos por relay 443: el edge de Cloudflare limitado a 80/443 más el NAT de operadora impiden la marcación directa en ambos sentidos. Un puente WebSocket por edge con un preámbulo de rol de 1 byte permite que ambos lados marquen hacia fuera (el teléfono abre cero puertos entrantes). Aterrizarlo implicó arreglar tres bugs reales — acuerdo de huella de build, autenticación de descarga por node-token, y un bug de longitud de trama con
Int.ushrde Kotlin que corrompía silenciosamente cada trama ≥ 64 KiB (ushrusa solo los 5 bits bajos del desplazamiento;len ushr 56se volviólen ushr 24) — corregido pasando a desplazamientosLong.
Un tejido de throughput, no un decodificador de baja latencia
La decodificación son 49 capas en serie, y una ida y vuelta por internet por capa cuesta 2.5–10 s por token. Así que la contienda del enjambre es servir modelos que nadie puede hospedar solo, medida en throughput agregado: el dispatch por lotes amortiza el RTT, el backbone mantiene una caché de hot-experts y las peticiones se enrutan a réplicas cercanas. La ruta de baja latencia queda en el anillo de pipeline.
M0 → M4
- M0 — offload de expertos del backbone a RAM: correr el 122B en un coordinador, sin cirugía de grafo.
- M1 — prueba expert-parallel en un solo host: mini-GGUF por expertos + runtime del worker + dispatch, logits exactamente iguales al monolítico.
- M2 — workers de teléfono en LAN + NAT computando expertos reales del 122B a través del relay 443.
- M3 — mercado de cobertura a grano de experto con réplicas y respaldo ante churn.
- M4 — throughput: dispatch por lotes + caché de hot-experts, tokens/s escalando con el número de workers.