Phase 0 — El motor: linkcpp, un plano de control para motor de inferencia
motor de inferencia trae un plano de datos RPC capaz pero sin plano de control. linkcpp añade la mitad que falta — descubrimiento, planificación, arranque y gateways — alrededor de binarios compilados cerca de upstream.
Todo lo que corre Kvasir empieza aquí. linkcpp es un plano de control de código disponible (Business Source License) alrededor del plano de datos RPC del motor de inferencia: ejecuta grandes modelos de IA en múltiples GPU y máquinas usando binarios ggml-rpc-server / llama-server compilados cerca de upstream. El plano de datos solo lleva un pequeño conjunto de parches — todo lo demás que añade linkcpp es orquestación.
Un plano de datos sin plano de control
motor de inferencia ya puede repartir un modelo entre máquinas por RPC — pero alguien tiene que descubrir las GPU, decidir qué capas van dónde, lanzar los workers correctos con los presupuestos correctos, comprobar que cada nodo habla el mismo protocolo y exponer una API que los desarrolladores puedan llamar. Hacerlo a mano para un clúster es un fastidio; hacerlo para una red abierta de dispositivos de desconocidos es imposible. Esa capa de coordinación es linkcpp.
Un hub, workers basados en upstream, gateways estándar
Flujo de la petición — el hub orquesta, los binarios basados en upstream computan.
browser / SDK
  → hub :19000                      # FastAPI control plane (single Docker image)
  → GPU-less llama-server master    # per-controller, :8080+
  → ggml-rpc-server workers         # local slots, remote units, managed agents
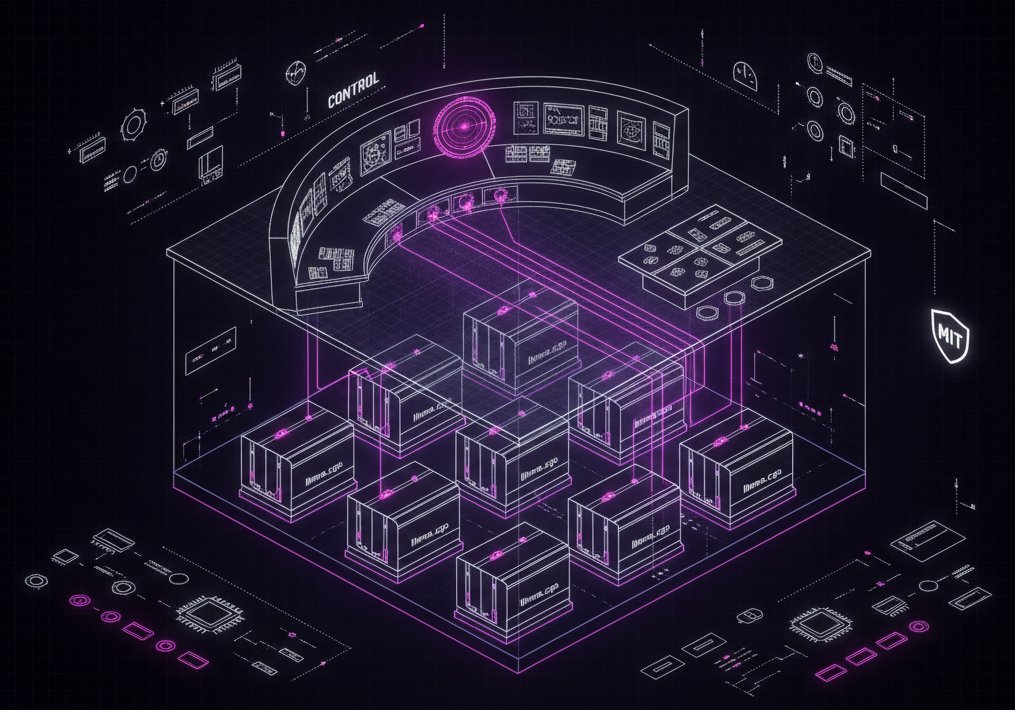
- Tres maneras de unirse: slots locales de nodo fijos con presupuestos VRAM/RAM/CPU editables; unidades remotas — registra otro hub e importa sus nodos; y agentes de nodo gestionados — servicios solo-worker que se unen por HTTP simple de petición/respuesta, deliberadamente sin stream persistente, para sobrevivir enrutamientos simples de LAN/VPN.
- El gating de compatibilidad es de primera clase: cada unidad, nodo y agente reporta una identidad de protocolo/runtime-pack más detalles de backend. Los desajustes de unidad, runtime-pack, revisión de motor de inferencia y ABI de RPC se bloquean duro antes de bind, plan, load o infer — las diferencias de backend (CUDA/Metal/Vulkan/CPU) se registran como capacidades, no rechazos.
- El planner lee metadata GGUF y produce colocación contigua de capas por nodo,
--tensor-split, estimaciones de VRAM de KV-cache/capa/experto, y offload opcional de FFN de expertos a RAM. - Gateways: cada controlador expone endpoints compatibles con OpenAI (
/v1/chat/completions,/v1/models) y con Anthropic (/anthropic/v1/messages|models), respaldados por el mismo modelo cargado — los clientes existentes funcionan sin cambios.
Esta separación deliberada — un plano de datos mantenido cerca de upstream bajo un plano de control de código disponible — es la base de todo lo posterior: el ring runtime, el mercado de capas y finalmente el enjambre de expertos son evoluciones del plano de control sobre el mismo cómputo.