Phase 7 — Throughput del dispatch por lotes (M4)
El enjambre es un tejido de throughput, no una jugada de latencia: agrupar las llamadas de dispatch amortiza el overhead por petición 77× por token.
Lotes más grandes, más tok/s por worker
| lote | tok/s por worker |
|---|---|
| 1 | 688 |
| 16 | 4,255 |
| 64 | 8,130 |
| 256 | 30,666 |
| 512 | 53,067 |
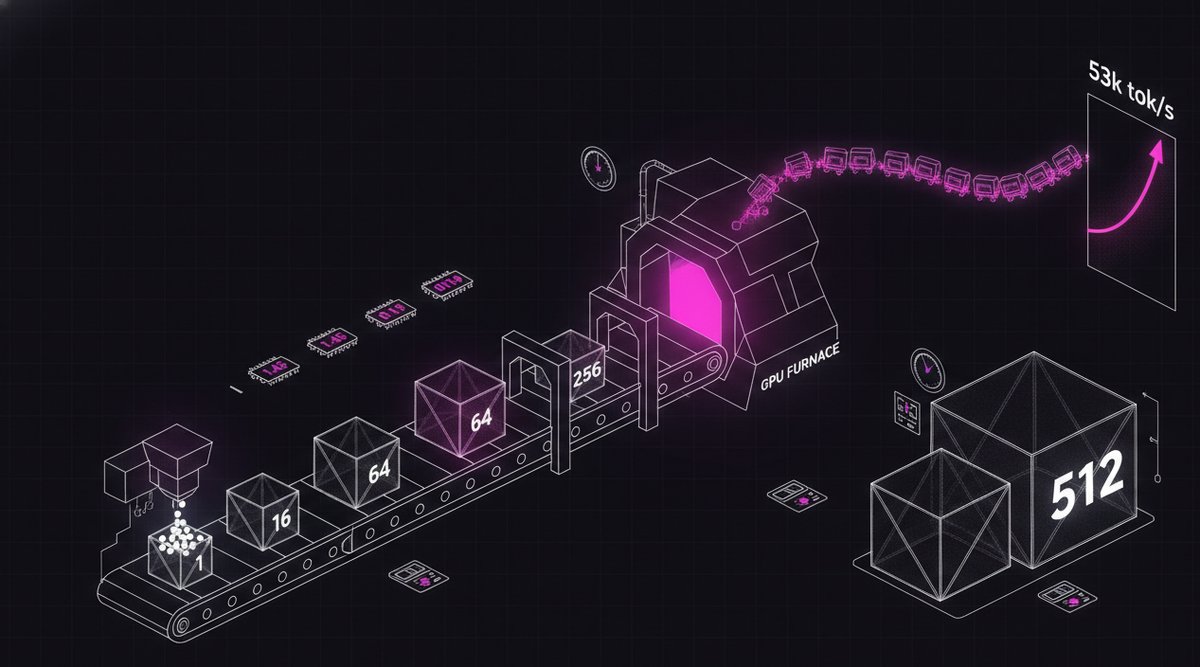
De 1.45 ms/tok con lote 1 a 0.019 ms/tok con lote 512 — una mejora de 77× por token. El tiempo por llamada apenas se mueve (1.45 → 9.6 ms) mientras el lote crece 512× — la GPU procesa el lote casi gratis tras un overhead fijo. Esta es la propiedad de tejido de throughput que hace práctico el expert-parallel: el dispatch por lotes amortiza el RTT y el overhead por petición.
Throughput del dispatch por lotes
- Worker
--bench: tiempos de compute_dispatch para lotes 1…512 → tok/s. - 53k tok/s por worker con lote 512 (ROCm) — el loteo amortiza el overhead.
- Sobre esto se apilan la caché de hot-experts y el escalado agregado multi-worker (enrutamiento de réplicas).
Con M4, toda la cadena M0 → M4 queda demostrada en un 122B real: offload del backbone · rebanadas de expertos · workers verificados · dispatch en decodificación en vivo (argmax MATCH) · procesos distribuidos · mercado de cobertura · throughput por lotes.