Del plano al hardware: lo verificado y la clave de bóveda
Recapitulación de la campaña de verificación — del diseño al núcleo de M2 probado en un 122B real — y la única pieza de integración que desbloquea el resto.
En las últimas semanas, las piezas difíciles y novedosas del enjambre de expertos se probaron una a una en un Qwen3.5-122B real — ni simulado, ni de juguete. He aquí el rastro de verificación hasta ahora, y la única clave de bóveda que quedaba.
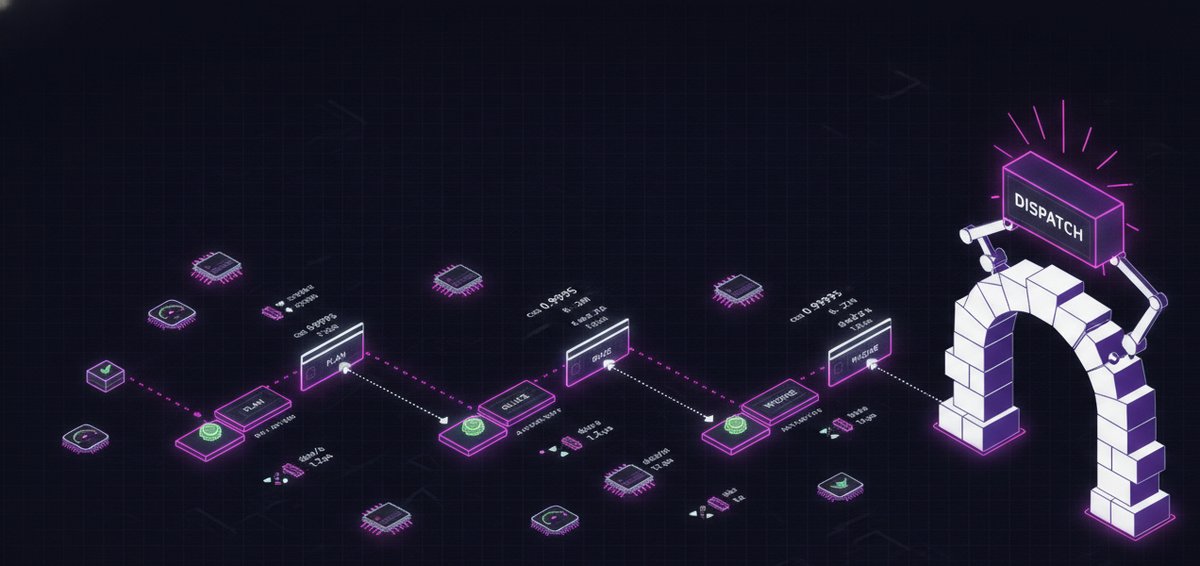
Lo que ya ha aterrizado
- Diseño (5 revisiones desde el plano) — arquitectura EP, participación autónoma con pesos parciales, el relay, la especificación del kernel del worker, y la equivalencia numérica entre backends codificada como tecnología central. La autoridad del router quedó escrita como el invariante de coherencia.
- M0 — offload de expertos del backbone a RAM (planner verificado): el 122B es *feasible* en un solo coordinador de 64 GB — 10 capas de expertos descargadas a RAM, VRAM 62.6 GiB / RAM 14.2 GiB, cableado vía
--override-tensor. - M1 — ruta de datos de rebanadas de expertos: sliceo de mini-GGUF por experto (losas ne[2], copia de bytes sin decuantización) + el endpoint de descarga
/expert-shard. - M1 — oráculo numérico: dispatch + combine == monolítico con max|Δ| = 3.6e-12 en expertos reales de layer-0 — el sharding es un reagrupamiento exacto de la misma suma ponderada.
- M1 — worker C++ en hardware:
linkcpp-expert-worker(ggml/gguf puro) compilado y ejecutado en ROCm, cosine 0.99995 vs el oráculo; router → dos workers C++ → combine iguala al monolítico con cosine 0.9997–0.9999. - Núcleo de M2 — un teléfono computa expertos reales del 122B: cross-build de Android, ejecutado en un SM-S938N, cosine 0.99992 vs el oráculo.
- Numéricos — matriz de equivalencia de 3 backends: la misma computación del 122B en ROCm × ARM CPU del teléfono × numpy — ROCm↔teléfono cosine 0.99990, ROCm↔numpy 0.99996, teléfono↔numpy 0.99992. Todo equivalente, nada bit-idéntico.
El dispatch del backbone, integrado en la decodificación en vivo
Cada componente — rebanadas, workers, lógica de dispatch/combine, equivalencia numérica, cómputo en teléfono — estaba verificado en dispositivo. Lo que faltaba era cablearlos dentro de una decodificación real de motor de inferencia: un hook en build_moe_ffn que despacha expertos a sus nodos dueños a mitad de grafo. Requirió modificar el submódulo fijado de motor de inferencia y varios ciclos de compilar-verificar. Con esta clave de bóveda en pie, la integración del relay de M2, el mercado de cobertura de M3 y el throughput por lotes de M4 se abren en secuencia — todos dependen de este dispatch.
La clave de bóveda ya aterrizó: las entradas siguientes sobre M2, M3, M4 y la demo en vivo con el teléfono son el resultado de exactamente esta integración.