La cuestión de los 200G
Nuestros hubs de enjambre ya pueden enlazarse a 200 Gb/s con piezas de estantería — una viene integrada en el GB10. Esto es lo que una tubería gruesa le compra a un MoE distribuido, y lo único que no puede.
La premisa: la decodificación WAN está limitada por RTT, no por ancho de banda — nuestra hoja de ruta de comunicaciones mostró que los bytes son la parte fácil. Entonces, ¿qué cambia realmente cuando los hubs consiguen enlaces de 200 Gb/s? Casi todo lo relativo a la *capacidad*, y casi nada lo relativo a la *latencia*.
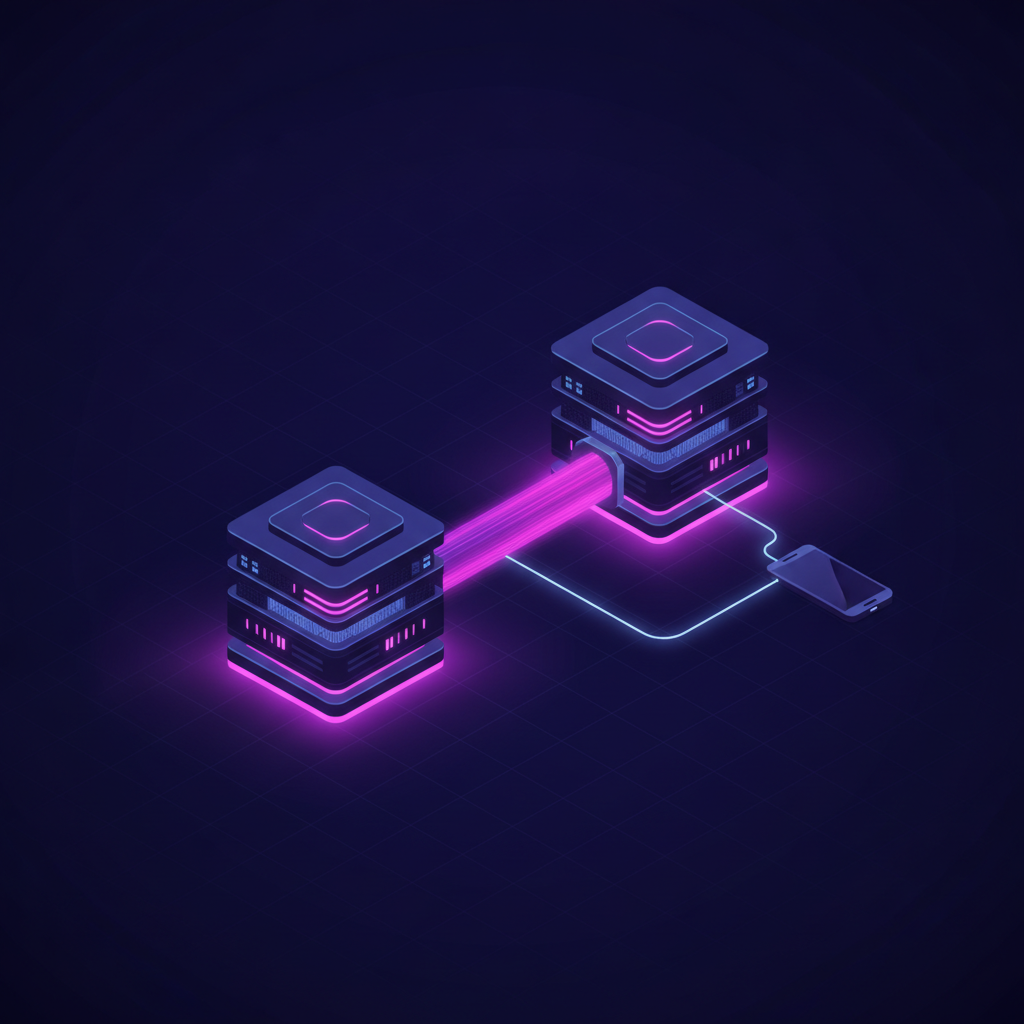
El hardware no es futurista — uno viene dentro de nuestro worker GB10
El GB10 Grace Blackwell que computa nuestros expertos del 122B lleva a bordo una NVIDIA ConnectX-7 con dos puertos QSFP de 200 GbE. Dos de estas máquinas se conectan directo con un único cable QSFP56 DAC de ~$100 — un clúster de dos hubs a 200G con cero switches. ARM es aquí un ciudadano de primera clase: la misma pila de drivers mlx5 que hace correr estas NIC en datacenters x86 las hace correr en aarch64, que es exactamente lo que es el GB10.
La letra pequeña: el GB10 alimenta su ConnectX-7 a través de dos enlaces PCIe Gen5 x4 en modo multi-host. La velocidad plena medida (~185–190 Gb/s) requiere RoCE (RDMA) y una topología mapeada correctamente — un TCP ingenuo sobre una ruta mal mapeada se queda en ~95 Gb/s o peor. Las tuberías gruesas se compran con configuración, no solo con cables.
200G es un artículo de catálogo en cada alcance
| alcance | pieza | factor de forma |
|---|---|---|
| rack (0.5–3 m) | QSFP56 DAC de cobre | cable, ~$100 |
| sala (~30 m) | AOC óptico activo | cable |
| campus (2–10 km) | óptica 200G FR4 / LR4 | módulo QSFP56 |
| metro (~40 km) | óptica 200G ER4 | módulo QSFP56 |
| región (~120 km) | 400G ZR+ coherente, a tasa de línea 200G | módulo QSFP-DD |
| larga distancia (cientos de km) | longitud de onda 200G de operadora / sistema de línea DWDM | servicio arrendado |
En la WAN, el *cable* es simplemente fibra monomodo estándar — vidrio neutral a la velocidad que ya recorre cada ciudad. La velocidad vive en la óptica enchufable de cada extremo, y OpenZR+ convirtió los 200G-sobre-120 km en un módulo que enchufas a un switch, no en un proyecto de telecom. Más allá de eso, arriendas una longitud de onda.
Todo término de ancho de banda del enjambre se desvanece
- Una carga útil de dispatch (~110 KB/token/capa hoy, ~10 KB tras la hoja de ruta del cable) se serializa en microsegundos — el tamaño de la carga deja por completo de ser una restricción de diseño.
- Una rebanada de experto se envía en ~32 ms (794 MB, teórico) y un modelo 122B entero se sincroniza en ~3 s — el reequilibrio del mercado de cobertura y la incorporación de un nuevo hub se vuelven casi instantáneos.
- El prefill de contexto largo — la única fase genuinamente pesada en ancho de banda — se mueve a velocidad de cable, así que el tiempo hasta el primer token en prompts de 100K tokens pasa a estar limitado por el cómputo del backbone.
- El dispatch por lotes escala sin techo de cable: el tráfico del pool de expertos agregado entre muchos streams de usuarios es exactamente la carga pesada en ancho de banda y tolerante a la latencia que una tubería gruesa absorbe. Esto es lo que hace práctica una federación multi-backbone — varios hubs, cada uno guardando el KV de sus propios usuarios, compartiendo un pool de expertos.
La luz no se apura
La fibra transporta luz a ~5 µs/km, y ninguna cantidad de ancho de banda cambia eso. Una ida y vuelta de 13 ms es 13 ms a 200 Gb/s. La decodificación autorregresiva paga esa ida y vuelta por capa fragmentada, por token — por eso la decodificación especulativa (k tokens por ida y vuelta) y el solapamiento del experto compartido (computar mientras el dispatch está en vuelo) siguen siendo esenciales incluso entre hubs unidos por la tubería más gruesa del mercado. El ancho de banda compra throughput; solo la disciplina de la ida y vuelta compra latencia.
Así que la arquitectura se asienta en dos niveles. Un nivel de hub — backbones y expertos calientes unidos por enlaces de clase 200G, donde la capacidad es efectivamente ilimitada — y un nivel de edge — teléfonos y dispositivos pequeños en el relay 443, que sostienen la larga cola de expertos que el mercado de escasez les asigna. La tubería gruesa hace que el primer nivel se sienta como una sola máquina; el relay mantiene el segundo nivel abierto a cualquiera. Ninguno reemplaza al otro: esa división *es* el diseño.