Inférence en essaim par sharding d'experts : la conception
86 % d'un MoE de 122B, ce sont 12 544 experts indépendants de 5.3 MB. Découpez le modèle à ce grain et un téléphone peut porter une part réelle de l'inférence de frontière.
La thèse : 86 % du poids de Qwen3.5-122B, ce sont 12 544 experts de 5.3 MB mutuellement indépendants. Shardez au grain de l'expert et un appareil faible porte « 8–64 experts (42–340 MB) » au lieu d'« une couche de 1.4 GB » — exactement l'unité qu'un téléphone peut réellement tenir. Le MoE est le substrat naturel d'un essaim.
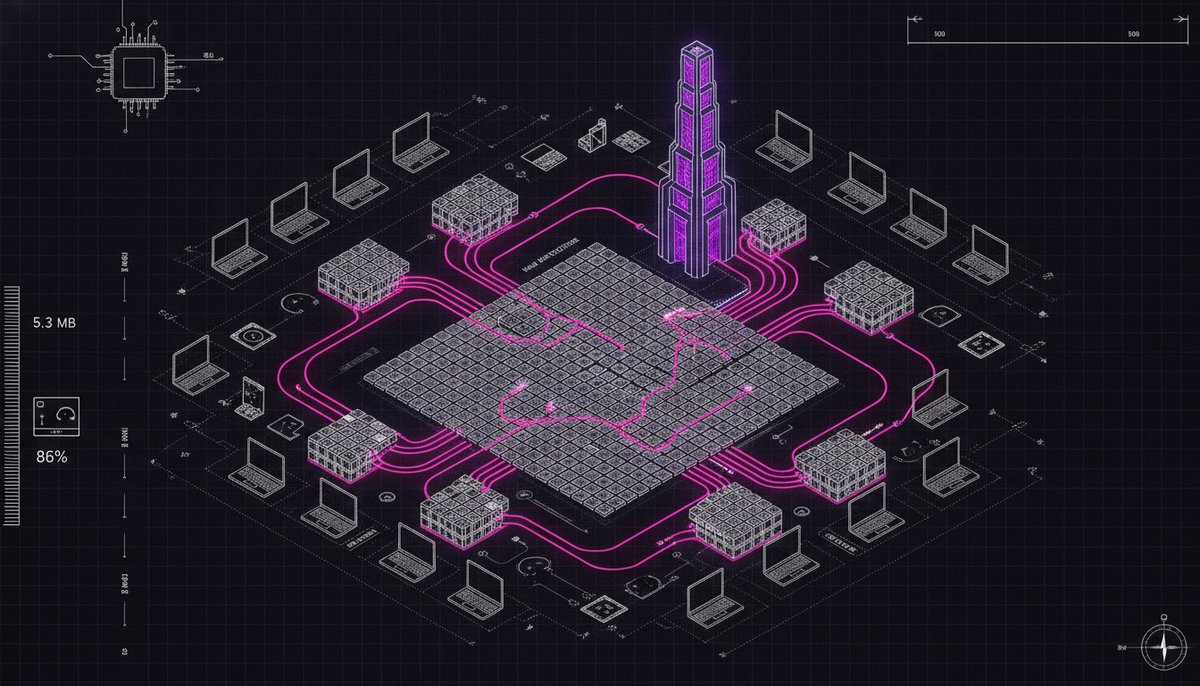
Les poids sont déjà conditionnés en unités à la taille de l'essaim
L'indice d'expert est la dimension la plus externe de chaque tenseur MoE : chaque expert est donc une dalle contiguë alignée sur les blocs de quantification. Un mini-GGUF découpé par experts est une copie propre de plage d'octets — sans déquantification, sans ré-empaquetage.
Stage backbone × worker d'experts
- Stage backbone (nœud fort) : attention + cache KV, toutes les norms, le routeur, l'expert partagé et le combine résiduel — toute la voie dense. Il garde aussi tous les experts résidents comme réplique de secours (offload en RAM), ce qui donne à l'essaim sa tolérance au churn.
- Worker d'experts (un téléphone) : pas un transformer. Ni attention, ni KV, ni sampler — une fonction pure
(hidden, local_ids) → outfaite de trois mat-muls, ne logeant que sa propre tranche d'experts. Elle tient dans n'importe quel budget, jusqu'au téléphone de 4 GB.
Le point de coupe : le routeur tourne une fois sur le backbone, avec autorité.
cur   = ffn_norm(x)                       # backbone
ids,p = top_k(softmax(cur @ router), 8)   # backbone — authoritative
── dispatch selected experts to owner nodes ──
send  (cur rows, local_ids)  →  worker    # ~6 KB per decode step
recv  expert_out             ←  worker
x = x + combine(p, partials) + shared(cur)  # backbone — numerically exact
Parce que le routeur tourne exactement une fois sur le backbone, chaque expert sélectionné est calculé exactement une fois par le nœud qui le possède. Aucune approximation — le sharding ne fait que déplacer l'endroit où se produisent les mat-muls.
L'essaim, c'est le marché de récompenses éprouvé, à grain plus fin
Kvasir opère déjà un marché autonome de rareté pour les shards de couches, vérifié sur appareils réels : un téléphone derrière NAT interroge la carte de demande, s'auto-inscrit sur le segment le mieux récompensé, ne télécharge partiellement que cette fenêtre, la charge sur son GPU Adreno et achève l'inférence en anneau — en gagnant des récompenses de contribution. Le sharding d'experts réutilise tout — carte de couverture, auto-inscription à récompense maximale, téléchargement partiel, récompenses par nœud — en ne changeant que l'unité de couverture : des *plages de couches* aux *(couche, plage d'experts)*.
Participation à poids partiels + le relais 443
- Téléchargement partiel des poids guidé par la récompense : les montages RPC/TP/PP classiques expédient le checkpoint complet à chaque rang, et un scheduler dicte le placement. Chez Kvasir, un nœud ne télécharge que la tranche qu'il va calculer, et choisit cette tranche lui-même, à la récompense — un mini-GGUF de stage de 254 MB contre le modèle complet de 77.6 GB. C'est ainsi qu'un téléphone de 4 GB rejoint un modèle bien plus grand que lui.
- Plan de données par relais 443 : la bordure Cloudflare limitée à 80/443 plus le NAT d'opérateur interdisent l'appel direct dans les deux sens. Un pont WebSocket par bordure avec un préambule de rôle d'1 octet permet aux deux côtés d'appeler vers l'extérieur (le téléphone n'ouvre aucun port entrant). L'atterrissage a exigé de corriger trois vrais bugs — accord d'empreinte de build, authentification de téléchargement par node-token, et un bug de longueur de trame
Int.ushrde Kotlin qui corrompait silencieusement chaque trame ≥ 64 KiB (ushrn'utilise que les 5 bits bas du décalage ;len ushr 56devenaitlen ushr 24) — corrigé en passant aux décalagesLong.
Un tissu de débit, pas un décodeur basse latence
Le décodage, ce sont 49 couches en série, et un aller-retour internet par couche coûte 2.5–10 s par token. L'enjeu de l'essaim est donc de servir des modèles que personne ne peut héberger seul, mesuré en débit agrégé : le dispatch par lots amortit le RTT, le backbone tient un cache de hot-experts, et les requêtes sont routées vers les répliques proches. La voie basse latence reste à l'anneau en pipeline.
M0 → M4
- M0 — offload des experts du backbone en RAM : faire tourner le 122B sur un coordinateur, sans chirurgie de graphe.
- M1 — preuve expert-parallel sur un seul hôte : mini-GGUF par experts + runtime du worker + dispatch, logits exactement égaux au monolithique.
- M2 — workers téléphone LAN + NAT calculant de vrais experts du 122B à travers le relais 443.
- M3 — marché de couverture au grain de l'expert avec répliques et repli anti-churn.
- M4 — débit : dispatch par lots + cache de hot-experts, tokens/s croissant avec le nombre de workers.