Phase 2 — À l'intérieur d'un MoE de 122B : pourquoi les poids veulent être shardés
Une analyse au niveau des tenseurs de Qwen3.5-122B : 86 % des octets sont 12 544 dalles d'experts indépendantes, chacune à une propre copie de plage d'octets de l'autonomie.
Avant de concevoir quoi que ce soit, nous avons démonté le 122B sur disque. La question : si un essaim d'appareils faibles doit porter ce modèle, quelle est l'unité naturelle de portage ? La réponse est tombée du layout des tenseurs GGUF lui-même.
De quoi une couche MoE est réellement faite
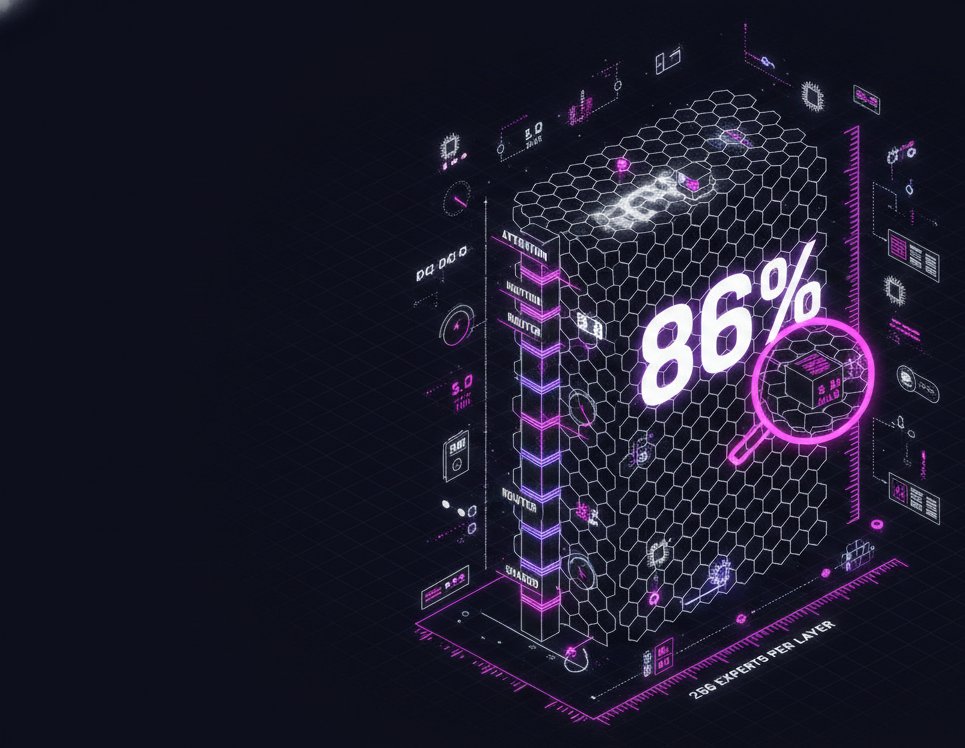
Chaque couche se scinde en une voie dense — attention + KV, les norms, le routeur (ffn_gate_inp), un expert partagé — et une banque d'experts : 256 FFN indépendantes stockées en trois tenseurs empilés (ffn_up_exps, ffn_gate_exps, ffn_down_exps). La voie dense est la minorité des octets ; la banque d'experts fait 86 % du modèle.
Les experts sont des dalles contiguës alignées sur les blocs
- L'indice d'expert est la dimension ggml la plus externe (
ne[2]) de chaque tenseur d'experts — l'expert *e* occupe une dalle contiguë, alignée sur les blocs de quantification, d'octets quantifiés bruts. - L'extraction par expert devient donc une copie de plage d'octets :
data[a:b], sans déquantification, sans ré-empaquetage — un mini-GGUF par experts est bon marché à produire et fidèle au bit. - Par token, seuls 8 experts sur 256 s'activent par couche, choisis par le routeur — au décodage, le trafic d'experts d'une couche se résume à quelques petites multiplications matricielles sur un vecteur hidden.
L'unité de portage passe de 1.4 GB à 5.3 MB
Au grain de la couche, le minimum qu'un nœud peut tenir est ~1.4 GB — hors de portée de la plupart des téléphones une fois que l'app, le KV et l'OS ont pris leur part. Au grain de l'expert, l'unité est 5.3 MB, et une contribution réaliste est de 8–64 experts (42–340 MB) — confortablement dans n'importe quel appareil moderne. Les experts étant mutuellement indépendants, la propriété peut être dispersée arbitrairement et rééquilibrée librement. C'est cette analyse qui a fait du sharding au niveau expert le pari de conception : les poids étaient déjà conditionnés en unités à la taille de l'essaim — le réseau n'avait qu'à honorer le conditionnement.