Phase 5 — Dispatch distribué d'experts (M2)
Un décodage 122B en direct confie le calcul d'experts d'une couche à un processus worker séparé via TCP — et prédit exactement le même token.
Décodage backbone → TCP → worker → experts → même token
Le worker d'experts sert la tranche de layer-0 en processus séparé (ROCm), et le callback de dispatch build_moe_ffn du backbone 122B expédie (cur, sel) via TCP et reçoit les sorties d'experts. Le cosine des logits est exactement la valeur in-process (0.99868775) — le transport est sans perte. Le calcul en essaim expert-parallel fonctionne à travers une frontière de processus.
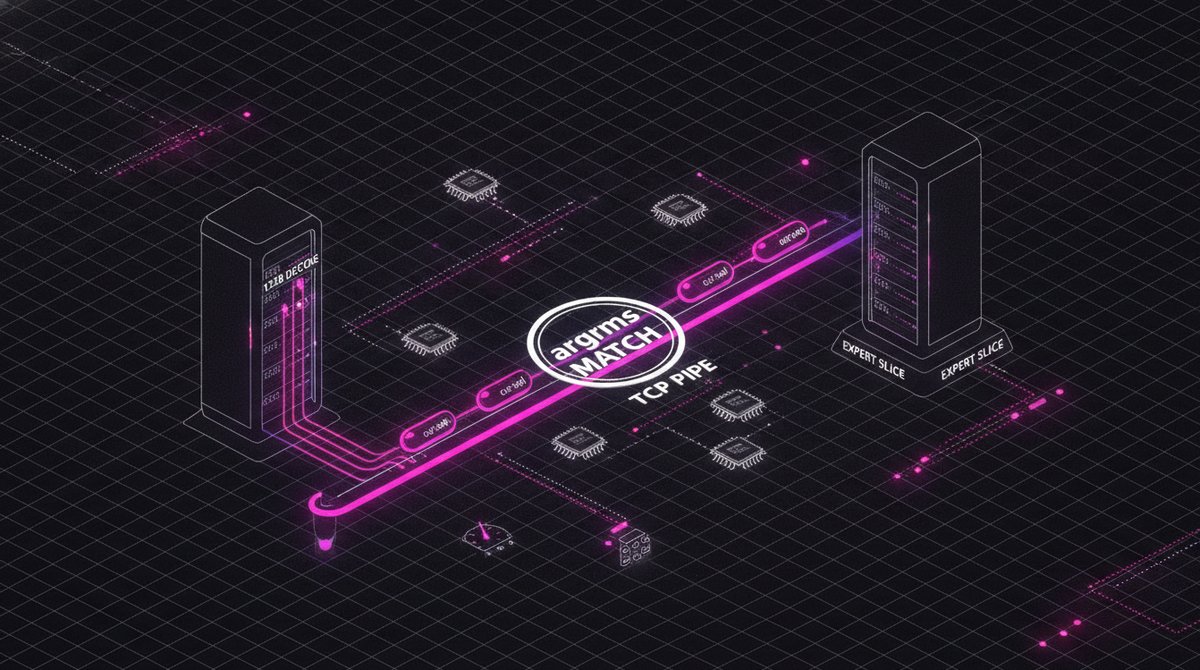
Une connexion TCP de longue durée — le même flux que l'anneau/le relais 443 peut tunneliser.
# worker: serving as a separate process
linkcpp-expert-worker --serve 52700 --model L0_all.gguf --layer 0 --n-embd 3072
# backbone: build_moe_ffn callback dispatches to the worker
linkcpp-moe-verify 122B.gguf ... --dispatch-port 52700
  → protocol: [n_used, n_tokens] + cur + sel  →  experts
La chaîne de dispatch distribué
- Mode
--serve: charger la tranche, écouter en TCP, répondre(n_used, n_tokens, cur, sel) → experts. --dispatch-port: le callback du backbone envoie/reçoit via TCP vers un worker séparé, remplaçant le calcul in-process.- Mesuré sur un décodage 122B en direct avec layer-0 dispatché hors processus → argmax MATCH, cosine 0.99869 (= in-process, sans perte).
- Cœur de M2 (plus tôt) : l'ARM du téléphone a calculé de vrais experts du 122B à cosine 0.99992 (cross-build Android).
La suite : tunneliser le même flux TCP par le relais 443 vers des workers sur d'autres machines et téléphones (le transport a déjà été prouvé dans le travail de l'anneau), puis le marché de couverture M3 et le débit par lots M4.