Phase 7 — Débit du dispatch par lots (M4)
L'essaim est un tissu de débit, pas un jeu de latence : grouper les appels de dispatch amortit l'overhead par requête de 77× par token.
Mesuré · ROCm, FFN d'experts, n_used = 8
Plus gros lots, plus de tok/s par worker
| lot | tok/s par worker |
|---|---|
| 1 | 688 |
| 16 | 4,255 |
| 64 | 8,130 |
| 256 | 30,666 |
| 512 | 53,067 |
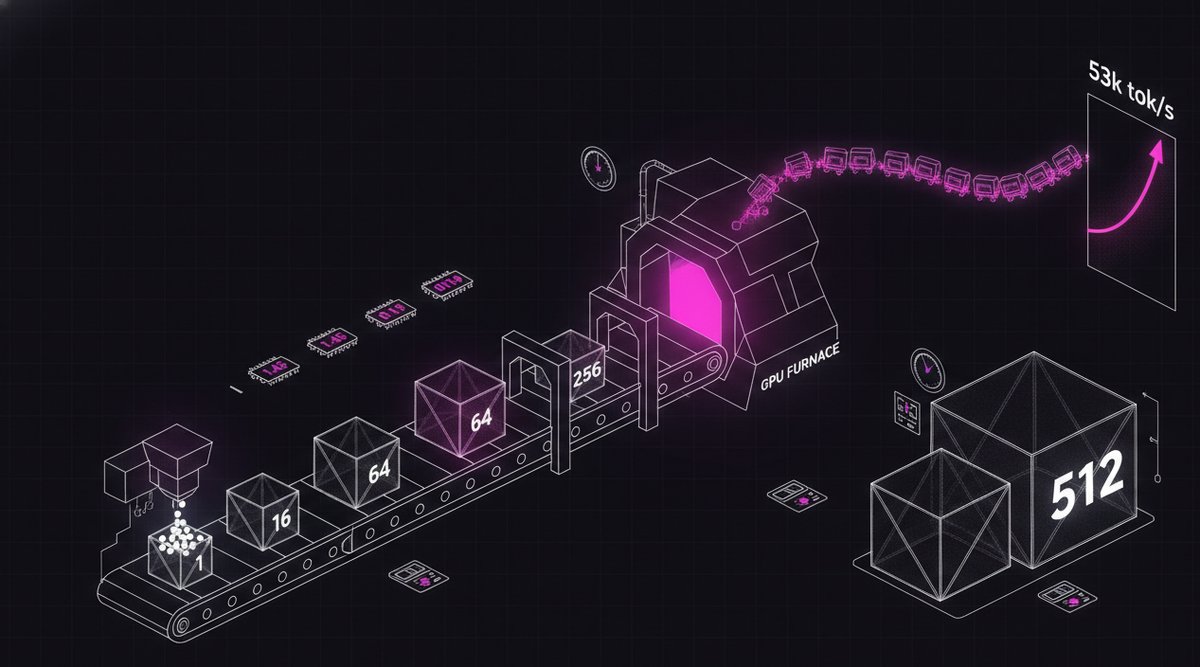
De 1.45 ms/tok au lot 1 à 0.019 ms/tok au lot 512 — une amélioration de 77× par token. Le temps par appel bouge à peine (1.45 → 9.6 ms) tandis que le lot grandit de 512× — le GPU traite le lot presque gratuitement derrière un overhead fixe. C'est la propriété de tissu de débit qui rend l'expert-parallel praticable : le dispatch par lots amortit le RTT et l'overhead par requête.
Fait
Débit du dispatch par lots
- Worker
--bench: chronométrages de compute_dispatch pour les lots 1…512 → tok/s. - 53k tok/s par worker au lot 512 (ROCm) — le lotissement amortit l'overhead.
- Là-dessus s'empilent le cache de hot-experts et la mise à l'échelle agrégée multi-workers (routage de répliques).
Avec M4, toute la chaîne M0 → M4 est démontrée sur un vrai 122B : offload du backbone · tranches d'experts · workers vérifiés · dispatch en décodage direct (argmax MATCH) · processus distribués · marché de couverture · débit par lots.