Phase 1 — L'anneau : inférence en pipeline sans master
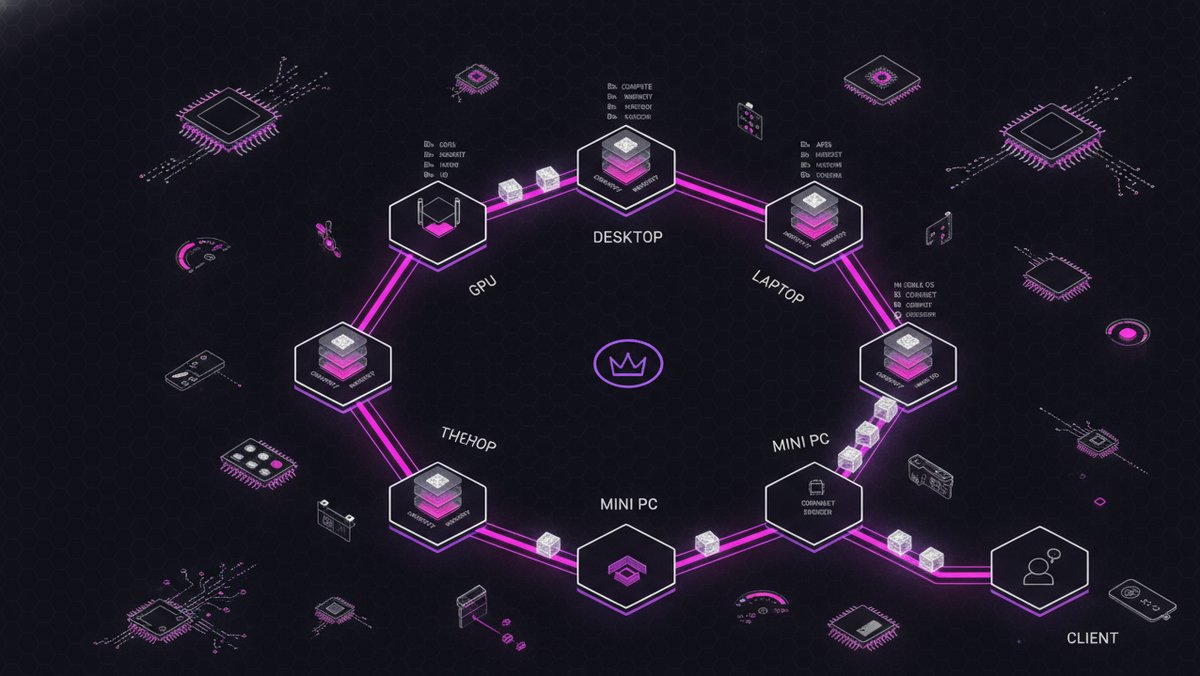
Chaque appareil ne charge que sa fenêtre de couches et passe une petite frontière de hidden-state à son voisin. Aucun nœud n'a besoin de détenir le modèle entier, et l'anneau n'a pas de master central.
Le master RPC est un goulot et un portier
Dans la topologie RPC classique, un master ouvre le GGUF entier et appelle chaque worker. Cette forme casse dans un réseau ouvert de trois façons : le master doit détenir et servir tout le checkpoint ; chaque worker doit être joignable — les téléphones derrière NAT d'opérateur ne le sont pas ; et le master est un propriétaire unique dans un réseau qui ne devrait en avoir aucun.
Fenêtres de couches + passage de frontières
- Chaque appareil stocke le même modèle mais ne charge que sa fenêtre de couches contiguë, puis ouvre exactement deux liens : un vers son prédécesseur, un vers son successeur.
- Une requête entre dans l'anneau ; chaque nœud exécute ses couches et ne passe que la frontière de hidden-state à son voisin. Le dernier rang échantillonne le token et le renvoie — pas de master central sur le chemin des données, et aucun nœud ne détient le modèle entier.
- Le placement vient du rank manifest du planner — pour Qwen3.5-122B, 49 couches réparties sur n'importe quel mélange de GPU, CPU, NPU et téléphone qui se présente.
Shards partiels, GPU mobiles et le relais 443
- Téléchargement de shard partiel : un stage de l'anneau n'a pas besoin du checkpoint — il a besoin de sa fenêtre. Un mini-GGUF de stage ne porte que ces tenseurs (254 MB pour 26 tenseurs contre le modèle complet de 77.6 GB), un téléphone ne tire donc que ~1.5 GB pour une fenêtre d'une couche.
- Voie GPU mobile : la route RPC vers le GPU d'un téléphone s'est révélée impraticable (la disposition des buffers OpenCL d'Adreno ne survit pas à la sérialisation RPC), mais un stage de l'anneau tourne directement sur le GPU Adreno — le stage possède son backend localement, donc rien ne traverse le fil sauf les frontières.
- Traversée de NAT : les téléphones ne peuvent accepter de connexions entrantes, le plan de données passe donc par un relais 443 — un pont WebSocket par bordure avec un préambule de rôle d'1 octet qui laisse les deux extrémités appeler vers l'extérieur. Le téléphone n'ouvre aucun port entrant.
- Marché d'auto-inscription : les stages se revendiquent, ne s'assignent pas. Un nœud interroge la carte de couverture/demande, choisit la fenêtre non couverte la mieux récompensée, la télécharge et rejoint — vérifié de bout en bout avec un téléphone derrière NAT achevant l'inférence en anneau et gagnant sa contribution.
La voie basse latence
L'anneau est la voie de latence de Kvasir : les frontières sont petites, les sauts peu nombreux, et le décodage circule sans rien rassembler au centre. Sa limite est la granularité — la plus petite unité qu'un nœud peut porter est une couche (~1.4 GB sur le 122B). Supprimer ce plancher, c'est le rôle de l'essaim d'experts ; l'anneau reste la colonne de service à laquelle il se branche.