La question du 200G
Nos hubs d'essaim peuvent déjà se relier à 200 Gb/s avec des pièces sur étagère — l'une est intégrée au GB10. Voici ce qu'un gros tuyau achète à un MoE distribué, et la seule chose qu'il ne peut pas.
La prémisse : le décodage WAN est borné par le RTT, pas par la bande passante — notre feuille de route de communication a montré que les octets sont la partie facile. Alors qu'est-ce qui change vraiment quand les hubs obtiennent des liens à 200 Gb/s ? Presque tout sur la *capacité*, et presque rien sur la *latence*.
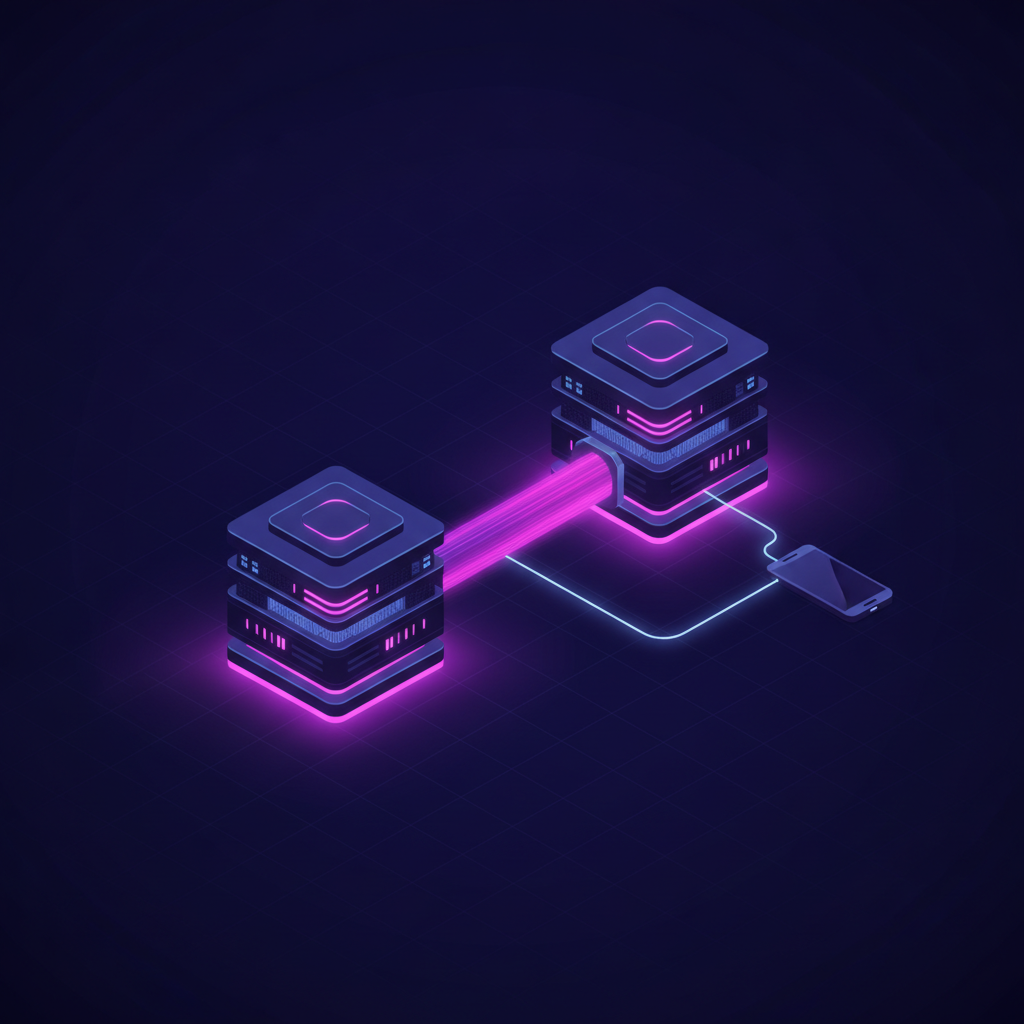
Le matériel n'a rien de futuriste — l'un est livré dans notre worker GB10
Le GB10 Grace Blackwell qui calcule nos experts du 122B embarque une NVIDIA ConnectX-7 avec deux ports QSFP 200 GbE. Deux de ces machines se connectent en direct avec un seul câble QSFP56 DAC à ~$100 — un cluster 200G à deux hubs avec zéro switch. ARM est ici un citoyen de premier ordre : la même pile de pilotes mlx5 qui fait tourner ces cartes réseau dans les datacenters x86 les fait tourner sur aarch64, ce qu'est exactement le GB10.
Les petits caractères : le GB10 alimente sa ConnectX-7 par deux liens PCIe Gen5 x4 en mode multi-hôte. La pleine vitesse mesurée (~185–190 Gb/s) exige RoCE (RDMA) et une topologie correctement mappée — un TCP naïf sur un chemin mal mappé atterrit à ~95 Gb/s ou pire. Les gros tuyaux s'achètent avec de la configuration, pas seulement des câbles.
Le 200G est un article de catalogue à toutes les portées
| portée | pièce | format |
|---|---|---|
| rack (0.5–3 m) | QSFP56 DAC cuivre | câble, ~$100 |
| salle (~30 m) | AOC optique active | câble |
| campus (2–10 km) | optiques 200G FR4 / LR4 | module QSFP56 |
| métro (~40 km) | optiques 200G ER4 | module QSFP56 |
| région (~120 km) | 400G ZR+ cohérent, exploité au débit ligne 200G | module QSFP-DD |
| longue distance (centaines de km) | longueur d'onde opérateur 200G / système de ligne DWDM | service loué |
Dans le WAN, le *câble* n'est que de la fibre monomode standard — du verre neutre en vitesse qui relie déjà chaque ville. La vitesse réside dans les optiques enfichables à chaque extrémité, et OpenZR+ a fait du 200G-sur-120 km un module qu'on enfiche dans un switch, pas un projet télécom. Au-delà, on loue une longueur d'onde.
Chaque terme de bande passante de l'essaim disparaît
- Une charge utile de dispatch (~110 KB/token/couche aujourd'hui, ~10 KB après la feuille de route sur le fil) se sérialise en microsecondes — la taille de la charge utile cesse totalement d'être une contrainte de conception.
- Une tranche d'experts s'expédie en ~32 ms (794 MB, théorique) et un modèle 122B entier se synchronise en ~3 s — le rééquilibrage du marché de couverture et l'intégration de nouveaux hubs deviennent quasi instantanés.
- Le prefill à long contexte — la seule phase réellement gourmande en bande passante — avance à la vitesse du fil, de sorte que le temps du premier token sur des prompts de 100K tokens devient borné par le calcul du backbone.
- Le dispatch par lots monte en charge sans plafond de fil : le trafic du pool d'experts agrégé sur de nombreux flux utilisateurs est exactement la charge gourmande en bande passante et tolérante à la latence qu'un gros tuyau absorbe. C'est ce qui rend praticable une fédération multi-backbone — plusieurs hubs, chacun gardant le KV de ses propres utilisateurs, partageant un pool d'experts.
La lumière ne se presse pas
La fibre porte la lumière à ~5 µs/km, et aucune quantité de bande passante n'y change rien. Un aller-retour de 13 ms reste 13 ms à 200 Gb/s. Le décodage autorégressif paie cet aller-retour par couche shardée, par token — c'est pourquoi le décodage spéculatif (k tokens par aller-retour) et le chevauchement de l'expert partagé (calculer pendant que le dispatch est en vol) restent essentiels, même entre des hubs reliés par le plus gros tuyau du marché. La bande passante achète du débit ; seule la discipline des allers-retours achète de la latence.
L'architecture se stabilise donc en deux paliers. Un palier hub — backbones et hot experts reliés par des liens de classe 200G, où la capacité est effectivement illimitée — et un palier de bordure — téléphones et petits appareils sur le relais 443, détenant la longue traîne d'experts que le marché de rareté leur attribue. Le gros tuyau donne au premier palier l'allure d'une seule machine ; le relais garde le second palier ouvert à tous. Aucun ne remplace l'autre : cette séparation *est* la conception.