Inferensi swarm dengan sharding pakar: desainnya
86% dari MoE 122B adalah 12.544 pakar independen berukuran 5.3 MB. Iris model pada butiran itu dan ponsel dapat memikul bagian nyata dari inferensi frontier.
Tesisnya: 86% bobot Qwen3.5-122B adalah 12.544 pakar 5.3 MB yang saling independen. Shard pada butiran pakar dan perangkat lemah memikul "8–64 pakar (42–340 MB)" alih-alih "satu lapisan 1.4 GB" — persis unit yang benar-benar bisa dipegang ponsel. MoE adalah substrat alami sebuah swarm.
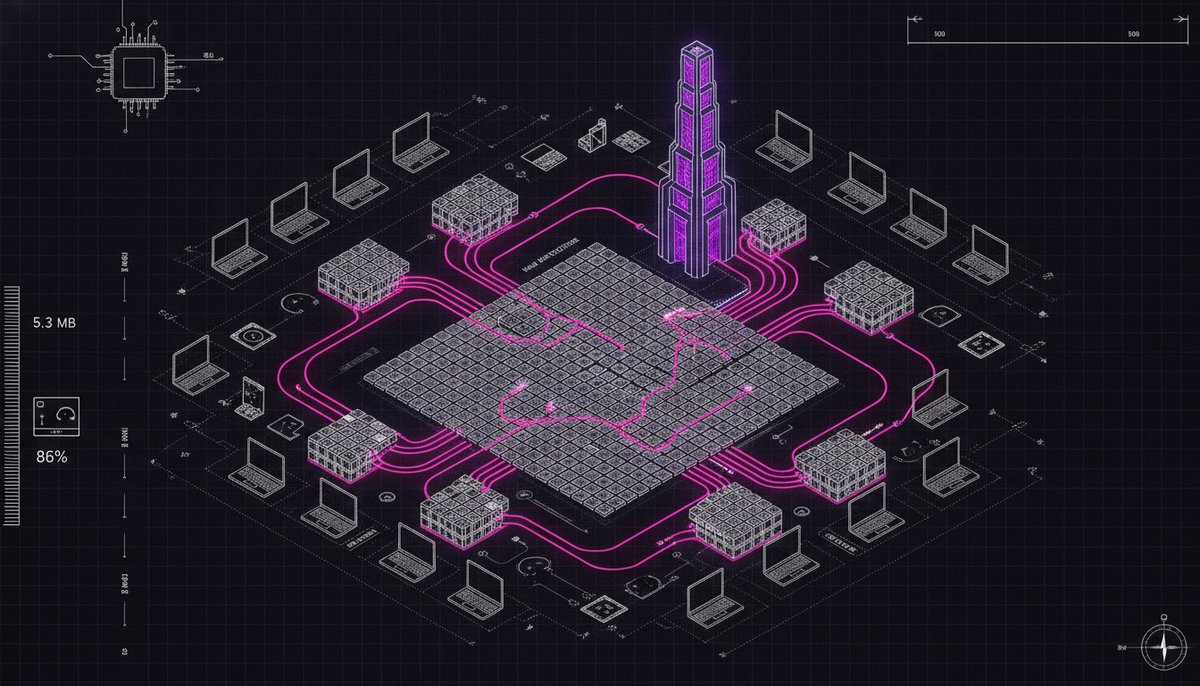
Bobotnya sudah terkemas dalam unit seukuran swarm
Indeks pakar adalah dimensi terluar dari setiap tensor MoE, sehingga tiap pakar adalah lempengan bersambung yang selaras blok-kuantisasi. Mini-GGUF hasil irisan pakar adalah salinan rentang byte yang bersih — tanpa dekuantisasi, tanpa pengemasan ulang.
Stage backbone × worker pakar
- Stage backbone (node kuat): attention + cache KV, semua norm, router, pakar bersama, dan combine residual — seluruh jalur padat. Ia juga menyimpan semua pakar sebagai replika cadangan (offload RAM), yang memberi swarm toleransi churn.
- Worker pakar (ponsel): bukan transformer. Tanpa attention, tanpa KV, tanpa sampler — fungsi murni
(hidden, local_ids) → outdari tiga mat-mul, hanya memuat irisan pakarnya sendiri. Muat di anggaran mana pun, hingga ponsel 4 GB.
Titik potong: router berjalan sekali di backbone, dengan otoritas.
cur   = ffn_norm(x)                       # backbone
ids,p = top_k(softmax(cur @ router), 8)   # backbone — authoritative
── dispatch selected experts to owner nodes ──
send  (cur rows, local_ids)  →  worker    # ~6 KB per decode step
recv  expert_out             ←  worker
x = x + combine(p, partials) + shared(cur)  # backbone — numerically exact
Karena router berjalan tepat sekali di backbone, tiap pakar terpilih dihitung tepat sekali oleh node yang memilikinya. Tidak ada aproksimasi — sharding hanya memindahkan tempat mat-mul terjadi.
Swarm = pasar imbalan yang terbukti, dengan butiran lebih halus
Kvasir sudah menjalankan pasar kelangkaan otonom untuk shard lapisan, terverifikasi di perangkat nyata: ponsel di balik NAT mem-poll peta permintaan, mendaftar mandiri ke segmen berimbalan tertinggi, mengunduh sebagian hanya jendela itu, memuatnya di GPU Adreno-nya, dan menuntaskan inferensi ring — sambil memperoleh imbalan kontribusi. Sharding pakar memakai ulang semuanya — peta cakupan, pendaftaran mandiri imbalan-maksimum, unduhan parsial, imbalan per node — hanya mengganti unit cakupan dari *rentang lapisan* menjadi *(lapisan, rentang pakar)*.
Partisipasi bobot parsial + relay 443
- Unduhan bobot parsial berbasis imbalan: susunan RPC/TP/PP konvensional mengirim checkpoint penuh ke tiap rank dan scheduler mendikte penempatan. Di Kvasir sebuah node hanya mengunduh irisan yang akan dihitungnya, dan memilih irisan itu sendiri, berdasarkan imbalan — mini-GGUF stage 254 MB versus model penuh 77.6 GB. Beginilah ponsel 4 GB bergabung dengan model yang jauh lebih besar dari dirinya.
- Bidang data relay 443: edge Cloudflare yang hanya 80/443 plus NAT operator berarti tak ada sambungan langsung di kedua arah. Jembatan WebSocket per edge dengan preamble peran 1 byte membuat kedua sisi menelepon keluar (ponsel membuka nol port masuk). Mendaratkannya berarti memperbaiki tiga bug nyata — kesepakatan sidik jari build, autentikasi unduhan node-token, dan bug panjang frame
Int.ushrKotlin yang diam-diam merusak tiap frame ≥ 64 KiB (ushrhanya memakai 5 bit terendah dari shift;len ushr 56menjadilen ushr 24) — diperbaiki dengan beralih ke shiftLong.
Jalinan throughput, bukan decoder latensi-rendah
Dekode adalah 49 lapisan serial, dan satu perjalanan pulang-pergi internet per lapisan memakan 2.5–10 dtk per token. Maka arena swarm adalah melayani model yang tak bisa di-host siapa pun sendirian, diukur dengan throughput agregat: dispatch berkelompok mengamortisasi RTT, backbone memelihara cache hot-expert, dan permintaan dirutekan ke replika terdekat. Jalur latensi-rendah tetap milik ring pipeline.
M0 → M4
- M0 — offload RAM pakar backbone: jalankan 122B di satu koordinator, tanpa bedah graf.
- M1 — bukti expert-parallel satu-host: mini-GGUF irisan pakar + runtime worker + dispatch, logits persis sama dengan monolitik.
- M2 — worker ponsel LAN + NAT menghitung pakar 122B nyata melalui relay 443.
- M3 — pasar cakupan butiran-pakar dengan replika dan fallback churn.
- M4 — throughput: dispatch berkelompok + cache hot-expert, tokens/s berskala dengan jumlah worker.