Phase 2 — Di dalam MoE 122B: mengapa bobot ingin di-shard
Analisis tingkat tensor Qwen3.5-122B: 86% byte-nya adalah 12.544 lempengan pakar independen, masing-masing tinggal satu salinan rentang byte bersih dari berdiri sendiri.
Sebelum merancang apa pun, kami membongkar 122B di disk. Pertanyaannya: jika swarm perangkat lemah hendak memikul model ini, apa unit angkut alaminya? Jawabannya jatuh dari tata letak tensor GGUF itu sendiri.
Dari apa sebenarnya satu lapisan MoE tersusun
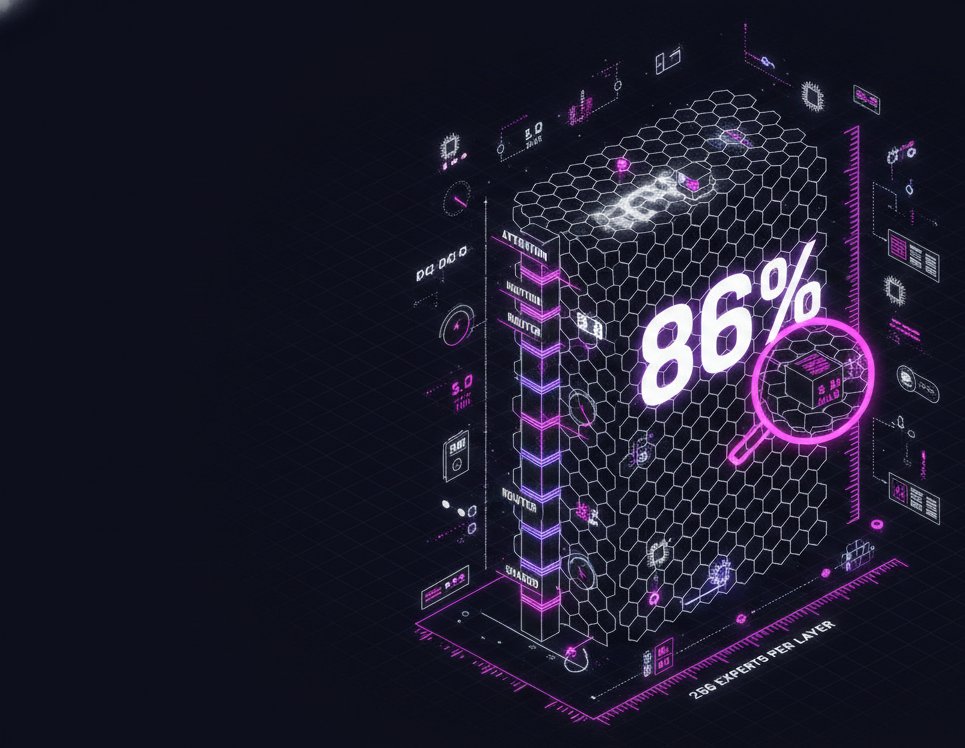
Tiap lapisan terbagi menjadi jalur padat — attention + KV, norm-norm, router (ffn_gate_inp), pakar bersama — dan bank pakar: 256 FFN independen yang disimpan sebagai tiga tensor bertumpuk (ffn_up_exps, ffn_gate_exps, ffn_down_exps). Jalur padat adalah minoritas byte; bank pakar adalah 86% model.
Pakar adalah lempengan bersambung yang selaras blok
- Indeks pakar adalah dimensi ggml terluar (
ne[2]) dari tiap tensor pakar — pakar *e* menempati satu lempengan bersambung, selaras blok-kuantisasi, berisi byte terkuantisasi mentah. - Itu membuat ekstraksi per pakar menjadi salinan rentang byte:
data[a:b], tanpa dekuantisasi, tanpa pengemasan ulang — mini-GGUF irisan pakar murah dibuat dan setia-bit. - Per token hanya 8 dari 256 pakar menyala per lapisan, dipilih router — jadi saat dekode, lalu lintas pakar satu lapisan hanyalah segelintir perkalian matriks kecil atas satu vektor hidden.
Unit angkut turun dari 1.4 GB ke 5.3 MB
Pada butiran lapisan, minimum yang bisa dipegang node adalah ~1.4 GB — di luar jangkauan kebanyakan ponsel begitu aplikasi, KV, dan OS mengambil bagiannya. Pada butiran pakar, unitnya 5.3 MB, dan kontribusi realistisnya 8–64 pakar (42–340 MB) — lapang di perangkat modern mana pun. Para pakar saling independen, sehingga kepemilikan bisa disebar sembarang dan diseimbangkan ulang bebas. Analisis inilah yang menjadikan sharding tingkat-pakar sebagai taruhan desain: bobotnya sudah terkemas dalam unit seukuran swarm — jaringan tinggal menghormati kemasannya.