Phase 7 — Throughput dispatch berkelompok (M4)
Swarm adalah jalinan throughput, bukan permainan latensi: mengelompokkan panggilan dispatch mengamortisasi overhead per permintaan 77× per token.
Terukur · ROCm, FFN pakar, n_used = 8
Batch lebih besar, tok/s per worker lebih tinggi
| batch | tok/s per worker |
|---|---|
| 1 | 688 |
| 16 | 4,255 |
| 64 | 8,130 |
| 256 | 30,666 |
| 512 | 53,067 |
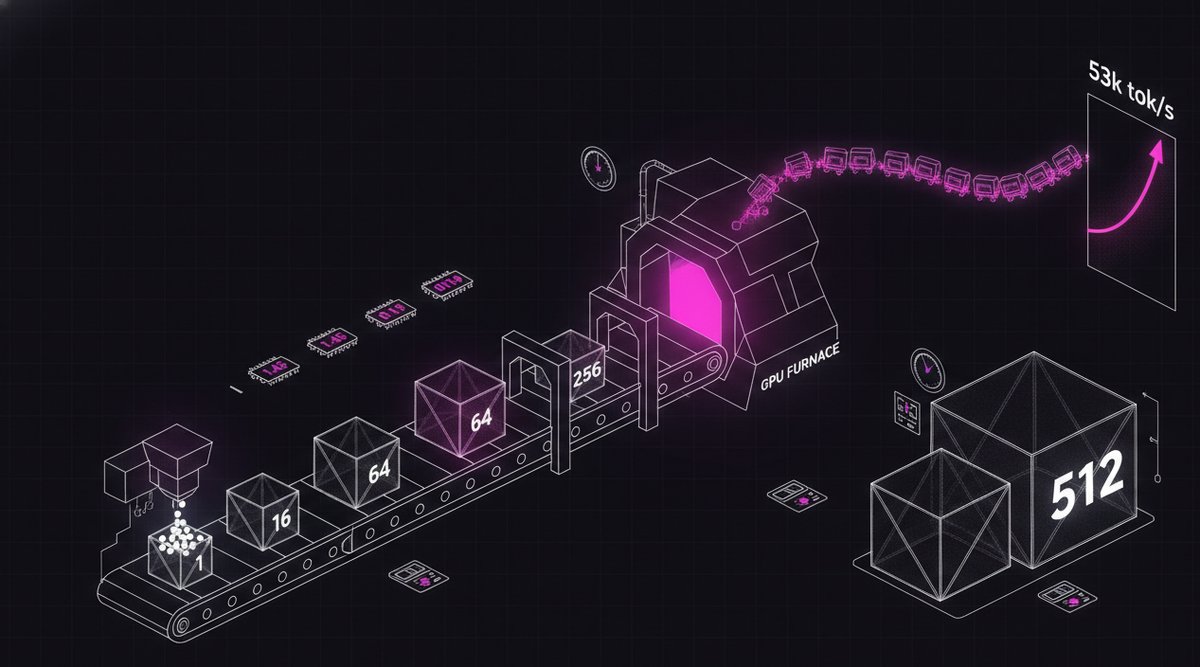
Dari 1.45 ms/tok pada batch 1 ke 0.019 ms/tok pada batch 512 — perbaikan 77× per token. Waktu per panggilan nyaris tak bergerak (1.45 → 9.6 ms) sementara batch tumbuh 512× — GPU memproses batch nyaris gratis di balik overhead tetap. Inilah sifat jalinan-throughput yang membuat expert-parallel praktis: dispatch berkelompok mengamortisasi RTT dan overhead per permintaan.
Selesai
Throughput dispatch berkelompok
- Worker
--bench: pewaktuan compute_dispatch untuk batch 1…512 → tok/s. - 53k tok/s per worker pada batch 512 (ROCm) — pengelompokan mengamortisasi overhead.
- Di atasnya bertumpuk cache hot-expert dan penskalaan agregat multi-worker (perutean replika).
Dengan M4, seluruh pipeline M0 → M4 terdemonstrasi pada 122B nyata: offload backbone · irisan pakar · worker terverifikasi · dispatch dekode langsung (argmax MATCH) · proses terdistribusi · pasar cakupan · throughput berkelompok.