Sebuah ponsel bergabung ke inferensi 122B
Sebuah Galaxy S25 mengunduh mandiri irisan pakarnya dari hub dan menghitung pakar satu lapisan di setiap langkah dekode 122B langsung. Keluarannya benar.
prompt: "The capital of France is" → dihasilkan (dengan ponsel dalam lingkar): " Paris." — 8/8 token identik dengan run lokal.
Terukur · 122B nyata, ponsel menghitung layer-0
Kebenaran + TPS
8/8
token identik dengan lokal
4.01
TPS lokal (garis dasar)
3.13
TPS dengan ponsel
1.58 GB
unduhan mandiri
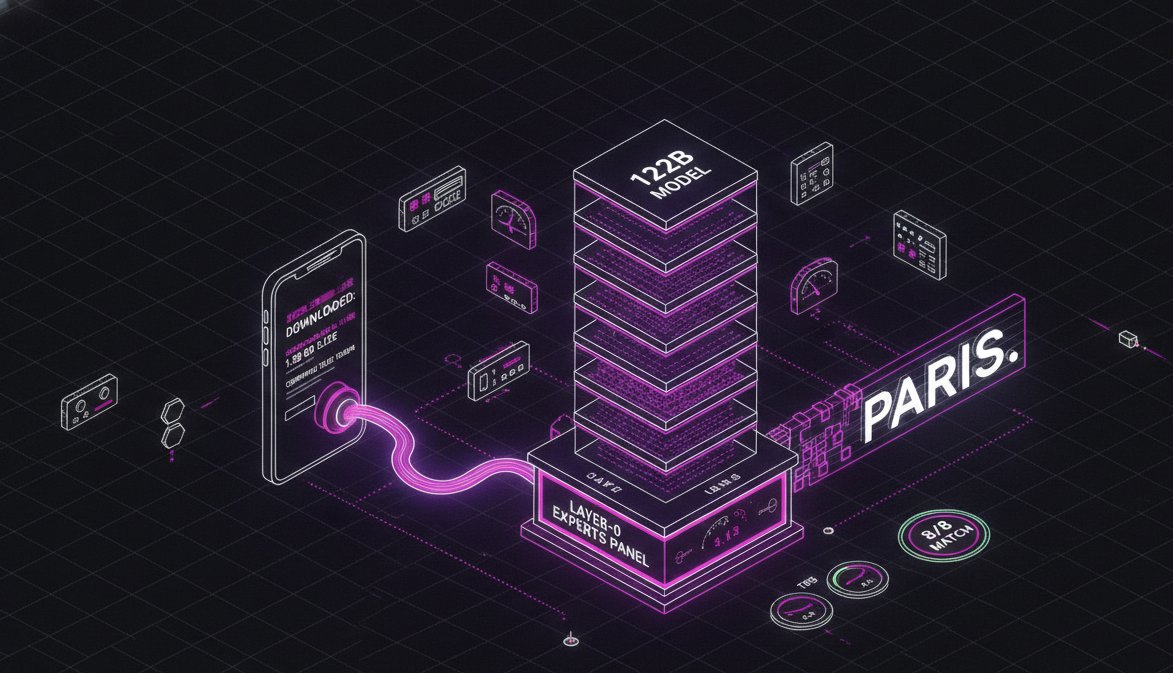
Bahkan dengan ponsel menghitung pakar layer-0 untuk setiap token, token yang dihasilkan persis sama dengan lokal — jawaban benar "Paris.". TPS turun dari 4.01 ke 3.13 — perjalanan pulang-pergi dispatch ponsel (MI250 → terowongan → ponsel, ~100 ms/token) memakan 22%. Throughput kembali dengan pengelompokan dan replika (M4).
Alur partisipasi otonom
Temukan → unduhan berbasis imbalan → ikut menghitung
1. Phone knows the hub (hub.kvasir-ai.net — retired since; the bridge serves this)
2. GET /api/proxy/models/…/expert-shard?layers=0:1&experts=0:256
   # partially downloads its own expert slice (1.58 GB, WiFi)
3. linkcpp-expert-worker --serve
   # loads the slice (Adreno device, CPU backend) + waits for dispatch
4. MI250 backbone decodes the 122B → every token, layer-0 experts
   dispatch to the phone → experts return → combine → "Paris."
   (8/8 identical to local)
Terverifikasi vs tersisa
Mekanismenya lengkap; loop dalam-aplikasi adalah produktisasi
- Unduhan parsial (endpoint expert-shard), penyajian worker, dispatch backbone, generasi 122B langsung, dan TPS — semua terverifikasi di perangkat nyata.
- Kebenaran: dengan ponsel berpartisipasi, 8/8 token sama dengan run lokal, dengan jawaban yang benar.
- Tersisa: loop otonom dalam-aplikasi (poll expert-demand → volunteer → unduh → serve → daftar) adalah pengkabelan Kotlin — demo ini menggerakkan mekanismenya langsung.
- Transport: demo ini memakai terowongan SSH; produksi memakai relay 443 (sudah terverifikasi di pekerjaan ring).