エキスパートシャーディング・スウォーム推論:設計
122B MoE の 86% は相互に独立した 5.3 MB のエキスパート 12,544 個。その粒度でモデルを切れば、スマートフォンもフロンティア推論の実質的な分担を負える。
テーゼ:Qwen3.5-122B の重みの 86% は、相互に独立した 5.3 MB のエキスパート 12,544 個だ。エキスパート粒度でシャーディングすれば、弱いデバイスが背負うのは「1.4 GB のレイヤー」ではなく「エキスパート 8–64 個(42–340 MB)」——まさにスマートフォンが実際に持てる単位である。MoE はスウォームの天然の基質だ。
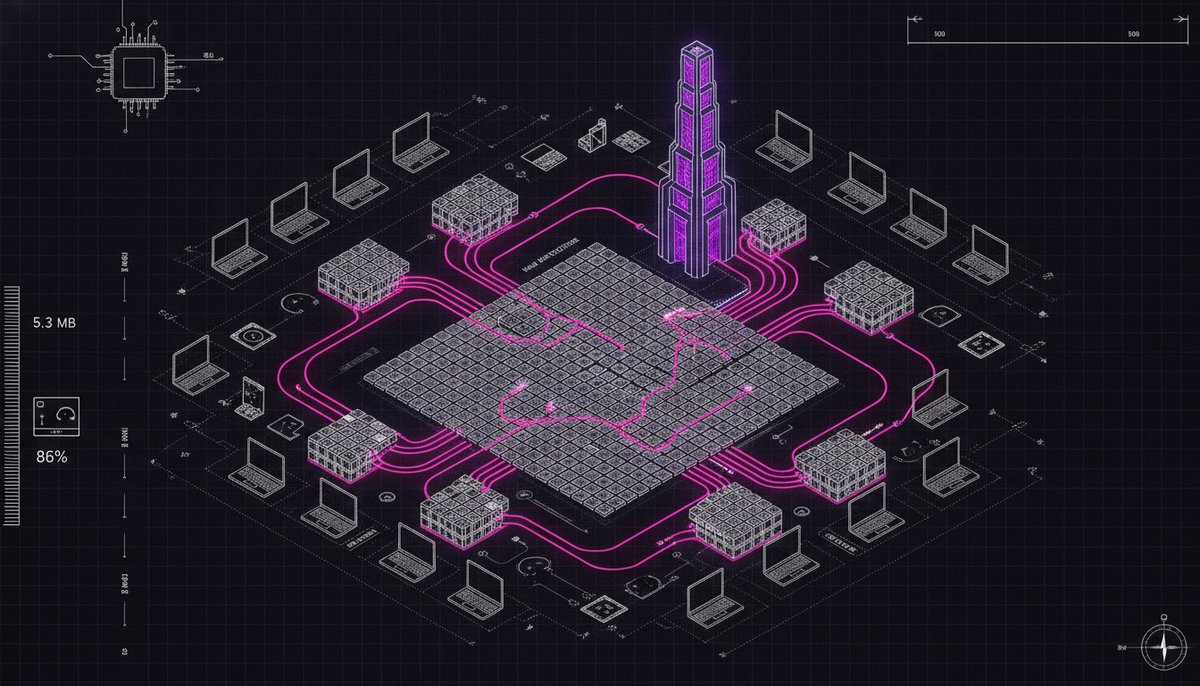
重みは最初からスウォームサイズの単位に梱包されている
エキスパートのインデックスはすべての MoE テンソルの最外次元であり、各エキスパートは連続した量子化ブロック整列のスラブだ。エキスパート単位でスライスした mini-GGUF はきれいなバイト範囲コピー——逆量子化も再パッキングも不要。
バックボーンステージ × エキスパートワーカー
- バックボーンステージ(強いノード):アテンション + KV キャッシュ、すべての norm、ルーター、共有エキスパート、residual combine——デンスパスの全部。さらに全エキスパートをフォールバック複製(RAM オフロード)として常駐させ、スウォームにチャーン耐性を与える。
- エキスパートワーカー(スマートフォン):トランスフォーマーではない。アテンションも KV もサンプラーもない——3 回の行列積からなる純関数
(hidden, local_ids) → outで、自分のエキスパートスライスだけを常駐させる。4 GB のスマートフォンまでどんな予算にも収まる。
カット地点:ルーターはバックボーンで一度だけ、権威をもって走る。
cur   = ffn_norm(x)                       # backbone
ids,p = top_k(softmax(cur @ router), 8)   # backbone — authoritative
── dispatch selected experts to owner nodes ──
send  (cur rows, local_ids)  →  worker    # ~6 KB per decode step
recv  expert_out             ←  worker
x = x + combine(p, partials) + shared(cur)  # backbone — numerically exact
ルーターがバックボーンでちょうど一度走るため、選ばれた各エキスパートは、それを所有するノードがちょうど一度計算する。近似は一切ない——シャーディングは行列積が起きる場所を動かすだけだ。
スウォーム = 実証済みの報酬市場を、より細かく
Kvasir には既にレイヤーシャード用の自律的な希少性市場があり、実機検証済みだ:NAT 配下のスマートフォンが需要マップをポーリングし、最高報酬のセグメントにセルフエンロールし、そのウィンドウだけを部分ダウンロードして Adreno GPU にロードし、リング推論を完走——貢献報酬まで得た。エキスパートシャーディングはそのすべて——カバレッジマップ・最高報酬セルフエンロール・部分ダウンロード・ノード別報酬——を再利用し、カバレッジ単位だけを*レイヤー範囲*から*(レイヤー, エキスパート範囲)*に変える。
部分重み参加 + 443 リレー
- 報酬駆動の部分重みダウンロード:従来の RPC/TP/PP はフルチェックポイントを全ランクに配り、スケジューラが配置を指図する。Kvasir ではノードが自分が計算するスライスだけをダウンロードし、そのスライスを自分で、報酬に基づいて選ぶ——77.6 GB のフルモデルに対して 254 MB のステージ mini-GGUF。4 GB のスマートフォンが自分よりはるかに大きなモデルに参加する仕組みだ。
- 443 リレーのデータプレーン:Cloudflare の 80/443 限定エッジとキャリア NAT により、どちらの方向にも直接ダイヤルできない。1 バイトの role preamble を使うエッジごとの WebSocket ブリッジで両側がアウトバウンドにダイヤルする(スマートフォンが開くインバウンドポートはゼロ)。着地までに三つの実バグを修正した——ビルドフィンガープリントの一致、node-token ダウンロード認証、そして 64 KiB 以上のすべてのフレームを静かに破壊した Kotlin の
Int.ushrフレーム長バグ(ushrはシフト量の下位 5 ビットしか使わず、len ushr 56がlen ushr 24になった)——Longシフトへの移行で修正。
低レイテンシデコーダではなくスループットファブリック
デコードは 49 レイヤーの直列で、レイヤーごとのインターネット往復はトークンあたり 2.5–10 秒かかる。だからスウォームの勝負所は誰も単独でホストできないモデルを皆で提供すること——総スループットで測られる:バッチディスパッチが RTT を償却し、バックボーンが hot-expert キャッシュを保持し、リクエストは近い複製へルーティングされる。低レイテンシの経路はパイプラインリングが担う。
M0 → M4
- M0 — バックボーンのエキスパート RAM オフロード:グラフ手術なしにコーディネータ 1 台で 122B を実行。
- M1 — 単一ホストでのエキスパート並列証明:エキスパートスライス mini-GGUF + ワーカーランタイム + ディスパッチ、ロジットがモノリシックと厳密一致。
- M2 — LAN + NAT スマートフォンワーカーが 443 リレー越しに実 122B エキスパートを計算。
- M3 — 複製とチャーンフォールバックを備えたエキスパート粒度カバレッジ市場。
- M4 — スループット:バッチディスパッチ + hot-expert キャッシュ、ワーカー数に比例する tokens/s。