Phase 2 — 122B MoE の内側:重みはなぜシャーディングされたがるのか
Qwen3.5-122B のテンソルレベル分析:バイトの 86% は独立したエキスパートスラブ 12,544 個で、それぞれ一度のきれいなバイト範囲コピーで独り立ちできる。
何かを設計する前に、我々は 122B をディスク上で解剖した。問いはこうだ:弱いデバイスのスウォームがこのモデルを背負うなら、自然な運搬単位は何か?答えは GGUF テンソルレイアウトそのものから転がり出た。
解剖 · Qwen3.5-122B-A10B (Q4_K_M)
MoE のレイヤーは実際に何でできているか
49
レイヤー
256
エキスパート / レイヤー
8
トークンごとに活性
12,544
エキスパート総数
5.3 MB
エキスパート 1 個 (Q4)
86%
重みに占める割合
3072
n_embd
77.6 GB
フルチェックポイント
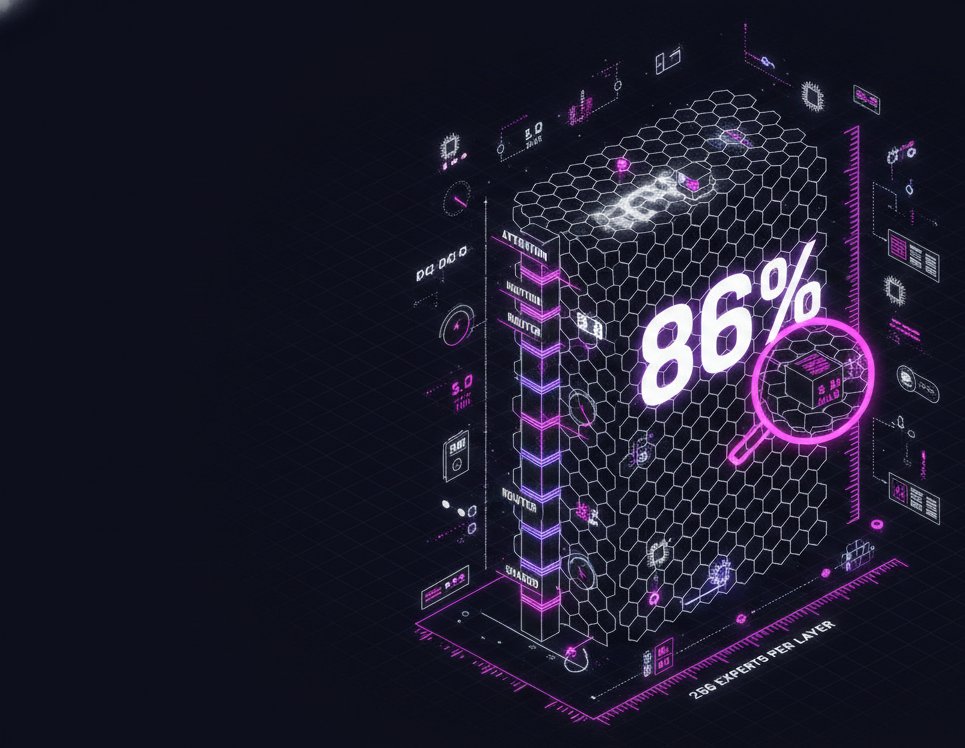
各レイヤーはデンスパス——アテンション + KV、各種 norm、ルーター(ffn_gate_inp)、共有エキスパート——と、三つの積層テンソル(ffn_up_exps、ffn_gate_exps、ffn_down_exps)として格納されるエキスパートバンク:独立した FFN 256 個に分かれる。デンスパスはバイトの少数派で、エキスパートバンクがモデルの 86% を占める。
レイアウトの贈り物
エキスパートは連続したブロック整列のスラブ
- エキスパートのインデックスはすべてのエキスパートテンソルの最外 ggml 次元(
ne[2])だ——エキスパート *e* は生の量子化バイトの、連続した量子化ブロック整列スラブを一枚占める。 - だからエキスパート単位の抽出はバイト範囲コピーになる:
data[a:b]、逆量子化なし、再パッキングなし——エキスパートスライスの mini-GGUF は安価に作れてビット忠実だ。 - トークンごとに各レイヤーでルーターが選ぶ 256 中 8 個だけが点火する——デコード時のレイヤーのエキスパートトラフィックは、hidden ベクトル一本への少数の小さな行列積にすぎない。
含意
運搬単位が 1.4 GB から 5.3 MB へ
レイヤー粒度では、ノードが持てる最小は約 1.4 GB——アプリ・KV・OS が取り分を持っていけば、ほとんどのスマートフォンには届かない。エキスパート粒度では単位は 5.3 MB で、現実的な貢献はエキスパート 8–64 個(42–340 MB)——どんな現代デバイスにも余裕で収まる。エキスパートは相互に独立なので、所有権は任意に散らばり自由に再バランスできる。この分析こそがエキスパートレベルのシャーディングを設計上の賭けにした:重みは最初からスウォームサイズの単位に梱包されていた——ネットワークはその梱包を尊重しさえすればよかった。