Phase 0 — エンジン:推論エンジン のコントロールプレーン linkcpp
推論エンジン には有能な RPC データプレーンがあるが、コントロールプレーンがない。linkcpp が欠けている半分——発見・計画・起動・ゲートウェイ——をアップストリームに近い形でビルドしたバイナリの周りに加える。
Kvasir が動くすべてはここから始まる。linkcpp は 推論エンジン の RPC データプレーンを包むソース公開のコントロールプレーン(Business Source License)だ:アップストリームに近い形でビルドした ggml-rpc-server / llama-server バイナリで、大型 AI モデルを複数の GPU とマシンにまたがって実行する。データプレーンが持つのは小規模なパッチセットだけだ——それ以外に linkcpp が加えるのはすべてオーケストレーションだ。
欠落
コントロールプレーンなきデータプレーン
推論エンジン はすでに RPC でモデルを複数マシンに分割できる——だが誰かが GPU を発見し、どのレイヤーをどこに置くか決め、正しい予算で正しいワーカーを起動し、全ノードが同じプロトコルを話すか検査し、開発者が実際に呼べる API を公開しなければならない。クラスタ一つなら手作業でも済むが、見知らぬ人々のデバイスからなるオープンネットワークでは不可能だ。その調整層が linkcpp である。
アーキテクチャ
ひとつの hub、アップストリームベースのワーカー、標準ゲートウェイ
リクエストの流れ——hub が編成し、アップストリームベースのバイナリが計算する。
browser / SDK
  → hub :19000                      # FastAPI control plane (single Docker image)
  → GPU-less llama-server master    # per-controller, :8080+
  → ggml-rpc-server workers         # local slots, remote units, managed agents
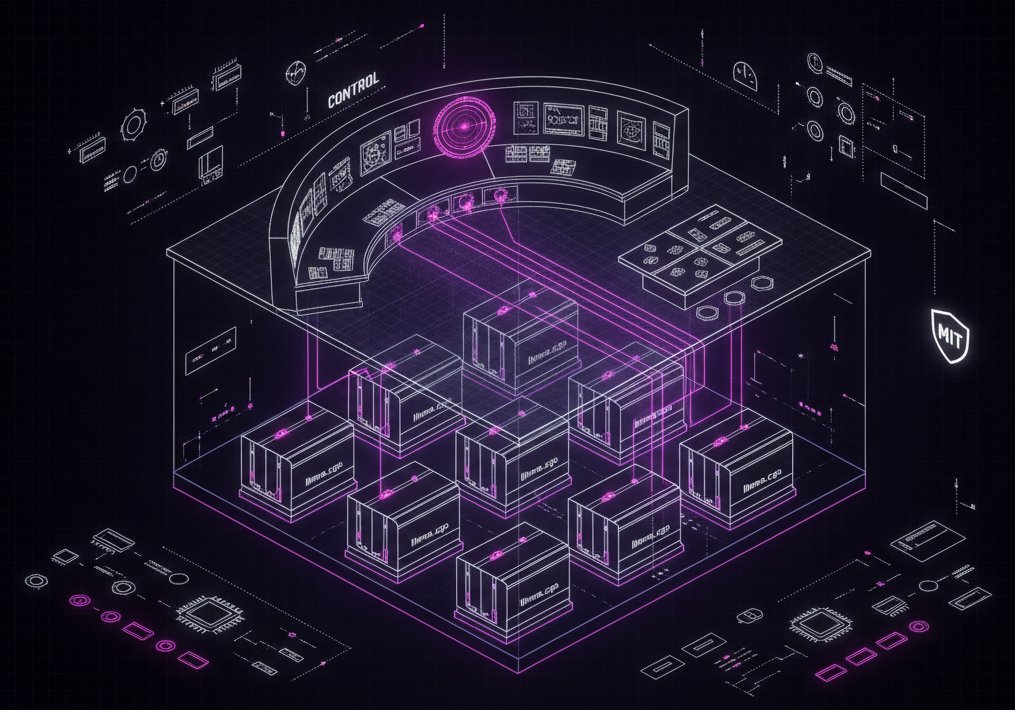
- マシンが参加する三つの方法:VRAM/RAM/CPU 予算を編集できる固定のローカルノードスロット;別の hub を登録してそのノードを取り込むリモートユニット;そしてマネージドノードエージェント——素朴なリクエスト/レスポンス HTTP で参加するワーカー専用サービスで、意図的に持続ストリームにせず、単純な LAN/VPN ルーティングでも生き残る。
- 互換性ゲーティングは一級の概念:すべてのユニット・ノード・エージェントがプロトコル/ランタイムパックの同一性とバックエンド詳細を報告する。ユニット・ランタイムパック・推論エンジン リビジョン・RPC ABI の不一致は bind/plan/load/infer の前にハードブロックされ、バックエンドの違い(CUDA/Metal/Vulkan/CPU)は拒否ではなく capability として記録される。
- プランナーは GGUF メタデータを読み、ノードごとの連続レイヤー配置、
--tensor-split、KV キャッシュ/レイヤー/エキスパート VRAM 見積もり、任意のエキスパート FFN RAM オフロードを生成する。 - ゲートウェイ:すべてのコントローラが OpenAI 互換(
/v1/chat/completions、/v1/models)と Anthropic 互換(/anthropic/v1/messages|models)のエンドポイントを、同じロード済みモデルで公開する——既存クライアントは無改造で動く。
この意図的な分離——ソース公開のコントロールプレーンの下の、アップストリームに近い状態に保たれたデータプレーン——が、後のすべての土台だ:リングランタイム、レイヤー市場、そして最終的にエキスパートシャーディング・スウォームまで、すべては同じ計算力の上のコントロールプレーンの進化である。