Phase 3 — バックボーンのエキスパート RAM オフロード (M0)
MoE エキスパート FFN を VRAM でなく CPU RAM からストリーミングすれば、64 GB のコーディネータ 1 台が 122B を収める——グラフ手術なしで。
エキスパート FFN が VRAM に住む必要はない。CPU RAM からストリーミングすれば、エキスパートが VRAM を超えるモデルをコーディネータ 1 台が収められる——弱いノードが大型 MoE に参加できるようにする土台だ。
プランナー検証 · 実 122B GGUF
122B が単一の 64 GB コーディネータに収まる
以前のリングは重みを VRAM のみに配置したため、122B(77.6 GB)は 64 GB GCD で infeasible だった。エキスパートオフロード規則を使うと、dry-run は feasible で返る:
feasible
122B リングプラン
62.6
VRAM GiB (≤ 64)
14.2
RAM GiB (エキスパート)
10
オフロードされたレイヤー
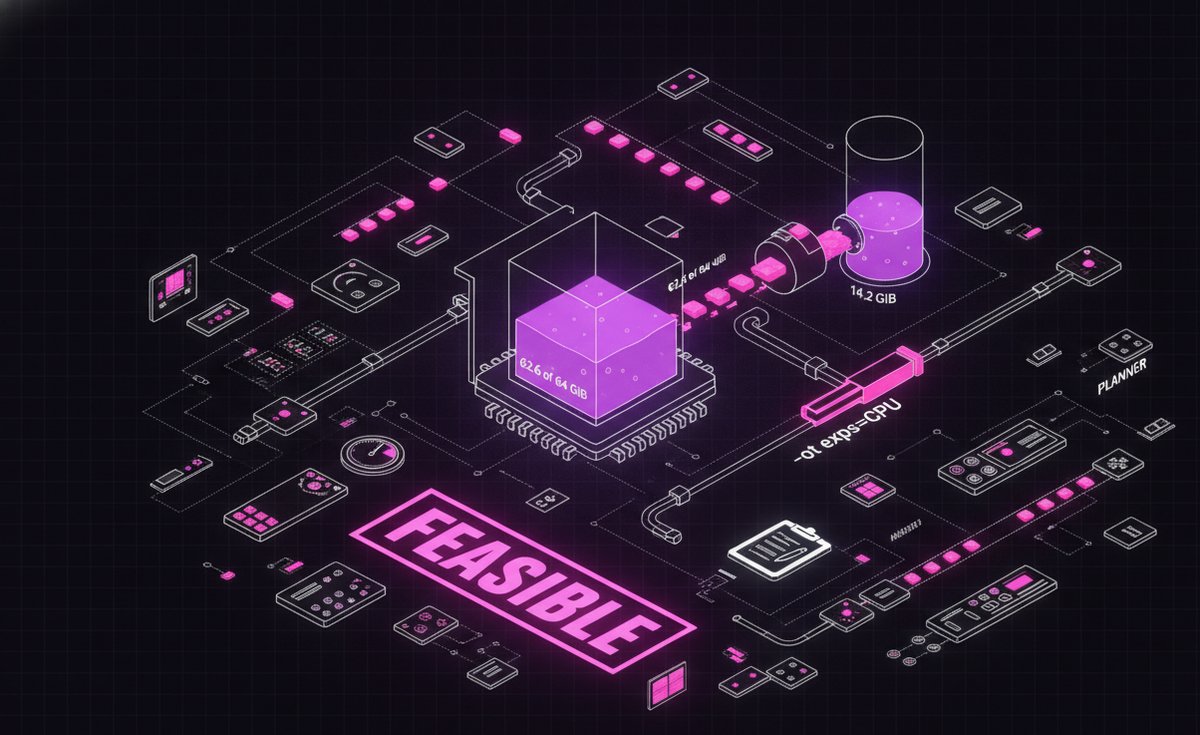
プランナー出力——推論エンジン の -ot 規則形式。
node 0  layers [0,48]  vram=62.6  ram=14.2  ot_rules=10
sample: blk\.38\.ffn_(up|down|gate)_(ch|)exps=CPU   # inference engine -ot format
何を配線したか · 純 Python、C++ 再ビルドなし
プランナーのオフロード規則を実ロードまで運ぶ
- planner — 各 placement に既に
ot(カンマ結合の-ot規則)を生成。 - protocol.py —
StageStartRequest.otフィールドを追加。 - runtime.py — placement の
otをステージリクエストへ転送。 - stage_service.py — コーディネータが
--override-tensorで起動。 linkcpp-serverは未知の引数を素の llama-server へ転送するため、-otはそのまま効く。
# stage_service.py — coordinator branch
if request.ot:
    command += ["--override-tensor", request.ot]
ot プロトコルの往復テストと、コーディネータコマンドが --override-tensor を出力する確認で検証し、hub は回帰なく再デプロイされた。当時の残り:完全な 2 ノード 77 GB ロード(オフロード付きコーディネータ + 約 1.5 GB の 1 レイヤーウィンドウを持つスマートフォン)で、サーバー可用性待ち。M0 の核心——弱いノードが大型 MoE に参加できるようにするバックボーンオフロード——はコードとプランナーのレベルで完結した。