Phase 7 — バッチディスパッチのスループット (M4)
スウォームはレイテンシ勝負ではなくスループットファブリックだ:ディスパッチ呼び出しをバッチ化すると、リクエストあたりのオーバーヘッドがトークンあたり 77 倍償却される。
実測 · ROCm、エキスパート FFN、n_used = 8
バッチが大きいほどワーカーあたりの tok/s が伸びる
| バッチ | ワーカーあたり tok/s |
|---|---|
| 1 | 688 |
| 16 | 4,255 |
| 64 | 8,130 |
| 256 | 30,666 |
| 512 | 53,067 |
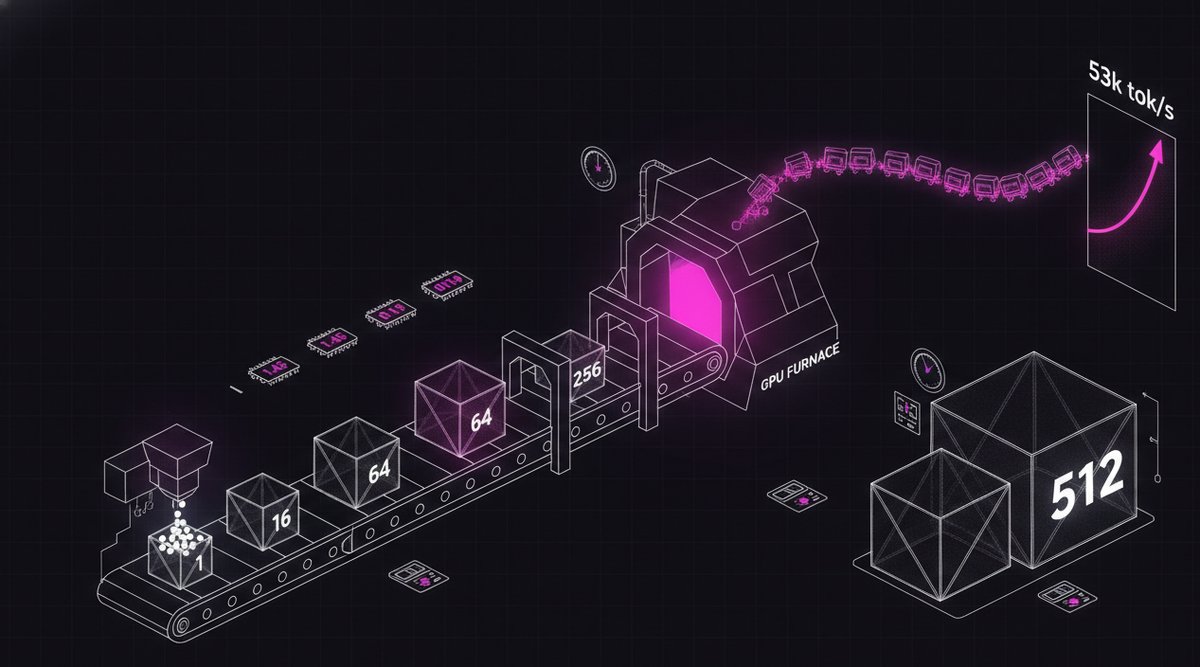
バッチ 1 の 1.45 ms/tok からバッチ 512 の 0.019 ms/tok へ——トークンあたり 77 倍の改善だ。呼び出しあたりの時間はほぼ動かないのに(1.45 → 9.6 ms)、バッチは 512 倍——GPU は固定オーバーヘッドの陰でバッチをほぼ無料で処理する。これがエキスパート並列を実用にするスループットファブリック特性だ:バッチディスパッチがリクエストあたりの RTT とオーバーヘッドを償却する。
完了
バッチディスパッチのスループット
- ワーカー
--bench:バッチ 1…512 の compute_dispatch 計時 → tok/s。 - バッチ 512(ROCm)でワーカーあたり 53k tok/s——バッチ化がオーバーヘッドを償却。
- この上に hot-expert キャッシュとマルチワーカー集約スケーリング(複製ルーティング)が積み上がる。
M4 をもって、M0 → M4 の全パイプラインが実 122B で実証された:バックボーンオフロード · エキスパートスライス · 検証済みワーカー · ライブデコードディスパッチ(argmax MATCH)· 分散プロセス · カバレッジ市場 · バッチスループット。