スマートフォンが 122B 推論に参加した
Galaxy S25 が hub から自分のエキスパートスライスを自律ダウンロードし、ライブ 122B デコードの毎ステップで 1 レイヤーのエキスパートを計算した。出力は正解だった。
prompt: "The capital of France is" → 生成結果(スマートフォン参加):" Paris." —— ローカル実行と 8/8 トークン一致。
実測 · 実 122B、スマホが layer-0 を計算
正確性 + TPS
8/8
トークンがローカルと一致
4.01
TPS ローカル (基準)
3.13
TPS スマホ参加
1.58 GB
自律ダウンロード
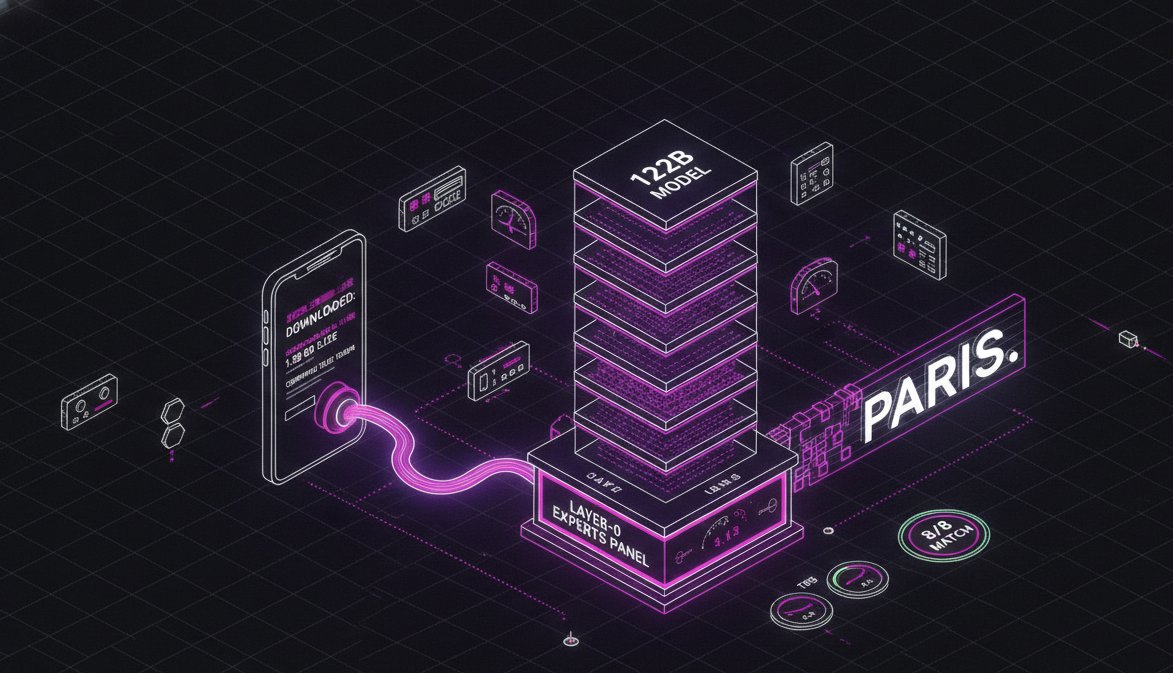
スマートフォンが毎トークン layer-0 のエキスパートを計算しても、生成トークンはローカルと完全に同じ——正解の "Paris." だ。TPS は 4.01 から 3.13 に下がる——スマホディスパッチの往復(MI250 → トンネル → スマホ、トークンあたり約 100 ms)が 22% を食う。スループットはバッチと複製で取り戻す(M4)。
自律参加のフロー
発見 → 報酬駆動ダウンロード → 計算に参加
1. Phone knows the hub (hub.kvasir-ai.net — retired since; the bridge serves this)
2. GET /api/proxy/models/…/expert-shard?layers=0:1&experts=0:256
   # partially downloads its own expert slice (1.58 GB, WiFi)
3. linkcpp-expert-worker --serve
   # loads the slice (Adreno device, CPU backend) + waits for dispatch
4. MI250 backbone decodes the 122B → every token, layer-0 experts
   dispatch to the phone → experts return → combine → "Paris."
   (8/8 identical to local)
検証済み vs 残り
機構は完結、アプリ内ループはプロダクション化
- 部分ダウンロード(expert-shard エンドポイント)、ワーカー提供、バックボーンディスパッチ、ライブ 122B 生成と TPS——すべて実機で検証。
- 正確性:スマートフォン参加時も 8/8 トークンがローカル実行と等しく、答えも正解。
- 残り:アプリ内自律ループ(expert-demand ポーリング → volunteer → ダウンロード → serve → 登録)は Kotlin の配線——このデモは機構を直接駆動した。
- 転送:このデモは SSH トンネルを使用;本番は 443 リレー(リングの作業で検証済み)。