전문가 샤딩 스웜 추론: 설계
122B MoE의 86%는 서로 독립적인 5.3 MB 전문가 12,544개다. 그 알갱이로 모델을 쪼개면 폰도 프런티어 추론의 실질적 몫을 질 수 있다.
테제: Qwen3.5-122B 무게의 86%는 상호 독립적인 5.3 MB 전문가 12,544개다. 전문가 단위로 샤딩하면 약한 기기는 "1.4 GB 레이어" 대신 "전문가 8–64개(42–340 MB)"만 지면 된다 — 폰이 실제로 감당할 수 있는 바로 그 단위다. MoE는 스웜의 천연 기질이다.
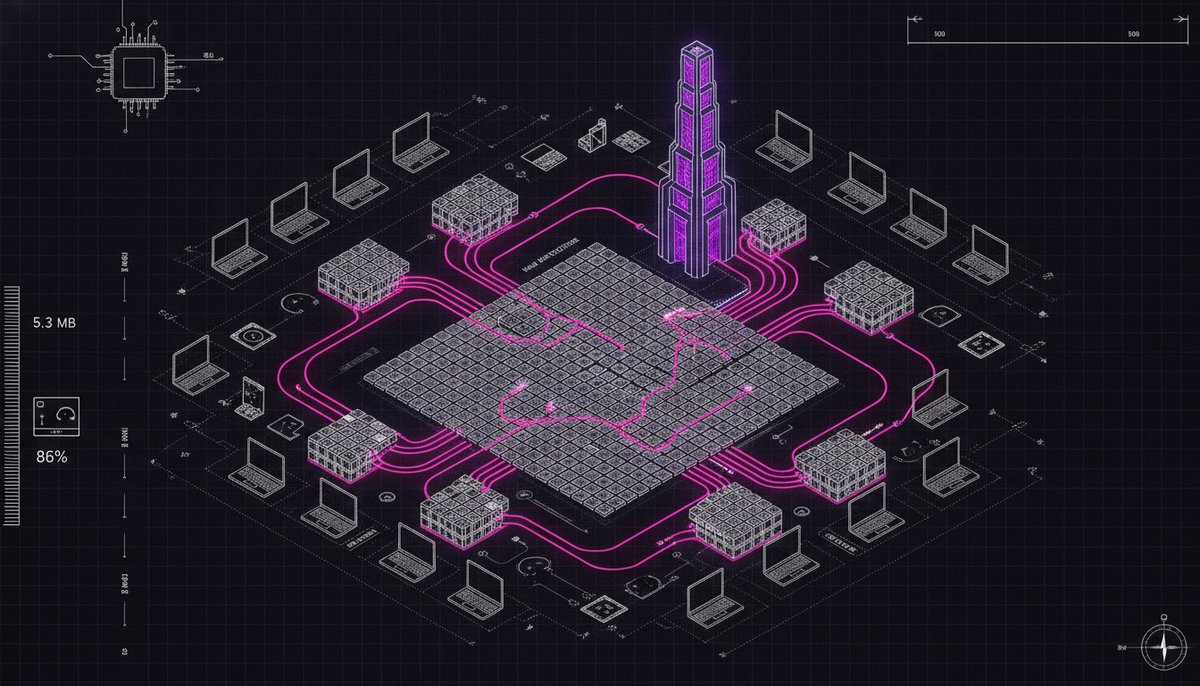
무게가 이미 스웜 크기의 단위로 포장돼 있다
전문가 인덱스는 모든 MoE 텐서의 최외곽 차원이라, 각 전문가는 연속된 양자블록 정렬 슬랩이다. 전문가 단위로 슬라이스한 mini-GGUF는 깨끗한 바이트 레인지 복사 — dequant도 re-pack도 없다.
백본 스테이지 × 전문가 워커
- 백본 스테이지(강한 노드): 어텐션 + KV 캐시, 모든 norm, 라우터, shared expert, residual combine — dense 경로 전부. 모든 전문가를 fallback 복제본(RAM offload)으로 상주시켜 스웜에 churn 내성을 준다.
- 전문가 워커(폰): 트랜스포머가 아니다. 어텐션도 KV도 샘플러도 없는 순수 함수
(hidden, local_ids) → out— mat-mul 3개로 이루어지며, 자기 전문가 슬라이스만 상주시킨다. 4 GB 폰까지 어떤 예산에도 맞는다.
컷 지점: 라우터는 백본에서 단 한 번, 권위를 갖고 실행된다.
cur   = ffn_norm(x)                       # backbone
ids,p = top_k(softmax(cur @ router), 8)   # backbone — authoritative
── dispatch selected experts to owner nodes ──
send  (cur rows, local_ids)  →  worker    # ~6 KB per decode step
recv  expert_out             ←  worker
x = x + combine(p, partials) + shared(cur)  # backbone — numerically exact
라우터가 백본에서 정확히 한 번 실행되므로, 선택된 전문가는 각자 소유 노드가 정확히 한 번씩 계산한다. 근사는 없다 — 샤딩은 mat-mul이 일어나는 위치만 옮길 뿐이다.
스웜 = 검증된 보상 마켓을, 더 잘게
Kvasir엔 이미 레이어 샤드용 자율 희소성 마켓이 있고 실기기 검증됐다: NAT 뒤의 폰이 수요 맵을 폴링해 최대 보상 구간에 self-enroll하고, 그 window만 부분 다운로드해 Adreno GPU에 로드하고, 링 추론을 완주해 기여 보상까지 받았다. 전문가 샤딩은 이 전부 — 커버리지 맵·최대보상 self-enroll·부분 다운로드·노드별 보상 — 를 그대로 재사용하고, 커버리지 단위만 *레이어 구간*에서 *(레이어, 전문가 범위)*로 바꾼다.
부분-가중치 참여 + 443 릴레이
- 보상 주도 부분-가중치 다운로드: 기존 RPC/TP/PP는 전체 체크포인트를 모든 rank에 내려보내고 스케줄러가 배치를 지시한다. Kvasir에서 노드는 자기가 계산할 슬라이스만 내려받고, 그 슬라이스를 스스로, 보상 기준으로 고른다 — 77.6 GB 전체 모델 대비 254 MB 스테이지 mini-GGUF. 4 GB 폰이 자기보다 훨씬 큰 모델에 참여하는 메커니즘이다.
- 443 릴레이 데이터 플레인: Cloudflare의 80/443 전용 엣지 + 캐리어 NAT는 양방향 직접 접속을 모두 막는다. 1바이트 role preamble을 쓰는 엣지별 WebSocket 브리지로 양쪽 모두 아웃바운드 접속한다(폰은 인바운드 포트 0개). 이를 안착시키며 실제 버그 셋을 잡았다 — 빌드 핑거프린트 정합, node-token 다운로드 인증, 그리고 64 KiB 이상 모든 프레임을 조용히 손상시킨 Kotlin
Int.ushr프레임 길이 버그(ushr은 시프트의 하위 5비트만 사용,len ushr 56이len ushr 24가 됨) —Long시프트로 수정.
저지연 디코더가 아니라 처리량 패브릭
디코드는 49레이어 직렬이고, 레이어당 인터넷 왕복은 토큰당 2.5–10초다. 그래서 스웜의 승부처는 아무도 혼자 못 올리는 모델을 함께 서빙하는 것 — 총처리량이다: 배치 dispatch가 RTT를 상각하고, 백본이 hot-expert 캐시를 유지하고, 요청은 가까운 복제본으로 라우팅된다. 저지연 경로는 파이프라인 링이 맡는다.
M0 → M4
- M0 — 백본 전문가 RAM offload: 그래프 수술 없이 코디네이터 한 대에서 122B 실행.
- M1 — 단일 호스트 expert-parallel 증명: expert-sliced mini-GGUF + 워커 런타임 + dispatch, 로짓이 monolithic과 정확히 일치.
- M2 — LAN + NAT 폰 워커가 443 릴레이 너머로 실제 122B 전문가 계산.
- M3 — 복제본·churn fallback을 갖춘 전문가 단위 커버리지 마켓.
- M4 — 처리량: 배치 dispatch + hot-expert 캐시, 워커 수에 비례하는 tokens/s.