Phase 2 — 122B MoE 해부: 가중치는 왜 쪼개지고 싶어 하는가
Qwen3.5-122B의 텐서 수준 분석: 바이트의 86%가 독립 전문가 슬랩 12,544개이며, 각각 바이트 레인지 복사 한 번이면 홀로 선다.
무언가를 설계하기 전에, 우리는 122B를 디스크 위에서 해부했다. 질문: 약한 기기들의 스웜이 이 모델을 지려면, 자연스러운 운반 단위는 무엇인가? 답은 GGUF 텐서 레이아웃 자체에서 떨어졌다.
해부 · Qwen3.5-122B-A10B (Q4_K_M)
MoE 레이어는 실제로 무엇으로 만들어지는가
49
레이어
256
전문가 / 레이어
8
토큰당 활성
12,544
전문가 총수
5.3 MB
전문가 1개 (Q4)
86%
무게 중 전문가 비중
3072
n_embd
77.6 GB
전체 체크포인트
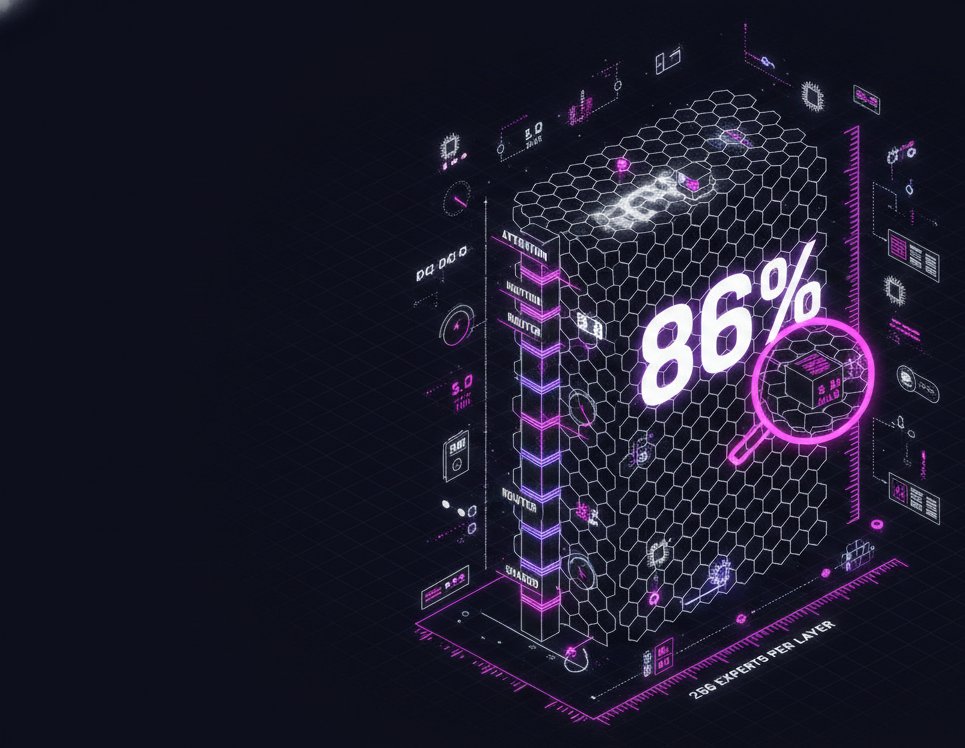
각 레이어는 dense 경로 — 어텐션 + KV, norm들, 라우터(ffn_gate_inp), shared expert — 와 세 개의 적층 텐서(ffn_up_exps, ffn_gate_exps, ffn_down_exps)로 저장되는 전문가 뱅크(독립 FFN 256개)로 나뉜다. dense 경로는 바이트의 소수이고, 전문가 뱅크가 모델의 86%다.
레이아웃의 선물
전문가는 연속된 블록 정렬 슬랩이다
- 전문가 인덱스는 모든 전문가 텐서의 최외곽 ggml 차원(
ne[2])이다 — 전문가 *e*는 원시 양자화 바이트의 연속·양자블록 정렬 슬랩 하나를 차지한다. - 그래서 전문가 단위 추출은 바이트 레인지 복사다:
data[a:b], dequant 없음, re-pack 없음 — expert-sliced mini-GGUF는 만들기 싸고 bit 단위로 충실하다. - 토큰당 레이어마다 라우터가 고른 256개 중 8개만 켜진다 — 디코드 시 레이어의 전문가 트래픽은 hidden 벡터 하나에 대한 소수의 작은 행렬곱이다.
함의
운반 단위가 1.4 GB에서 5.3 MB로
레이어 단위에서 노드가 질 수 있는 최소는 ~1.4 GB — 앱·KV·OS가 제 몫을 가져가면 대부분의 폰엔 무리다. 전문가 단위에서 단위는 5.3 MB이고, 현실적인 기여는 전문가 8–64개(42–340 MB) — 어떤 최신 기기에도 넉넉히 들어간다. 전문가들은 상호 독립적이라 소유권을 임의로 흩뿌리고 자유롭게 재조정할 수 있다. 이 분석이 전문가 수준 샤딩을 설계의 베팅으로 만들었다: 가중치는 이미 스웜 크기 단위로 포장돼 있었고 — 네트워크는 그 포장을 존중하기만 하면 됐다.