Phase 0 — 엔진: 추론엔진의 컨트롤 플레인, linkcpp
추론엔진에는 유능한 RPC 데이터 플레인은 있지만 컨트롤 플레인이 없다. linkcpp가 그 나머지 절반 — 탐색·계획·실행·게이트웨이 — 을 업스트림에 가깝게 빌드한 바이너리 둘레에 더한다.
Kvasir가 돌아가는 모든 것은 여기서 시작한다. linkcpp는 추론엔진의 RPC 데이터 플레인을 감싸는 소스 공개 컨트롤 플레인(Business Source License)이다: 업스트림에 가깝게 빌드한 ggml-rpc-server / llama-server 바이너리로 대형 AI 모델을 여러 GPU와 머신에 걸쳐 실행한다. 데이터 플레인에는 소규모 패치 세트만 들어간다 — 그 밖에 linkcpp가 더하는 것은 전부 오케스트레이션이다.
빈틈
컨트롤 플레인 없는 데이터 플레인
추론엔진는 이미 RPC로 모델을 여러 머신에 쪼갤 수 있다 — 하지만 누군가는 GPU를 탐색하고, 어느 레이어를 어디에 둘지 정하고, 알맞은 예산으로 알맞은 워커를 실행하고, 모든 노드가 같은 프로토콜을 쓰는지 검사하고, 개발자가 실제로 호출할 API를 노출해야 한다. 클러스터 하나면 손으로도 하지만, 낯선 이들의 기기로 이루어진 열린 네트워크에선 불가능하다. 그 조율 계층이 linkcpp다.
아키텍처
하나의 허브, 업스트림 기반 워커, 표준 게이트웨이
요청 흐름 — 허브가 조율하고, 업스트림 기반 바이너리가 계산한다.
browser / SDK
  → hub :19000                      # FastAPI control plane (single Docker image)
  → GPU-less llama-server master    # per-controller, :8080+
  → ggml-rpc-server workers         # local slots, remote units, managed agents
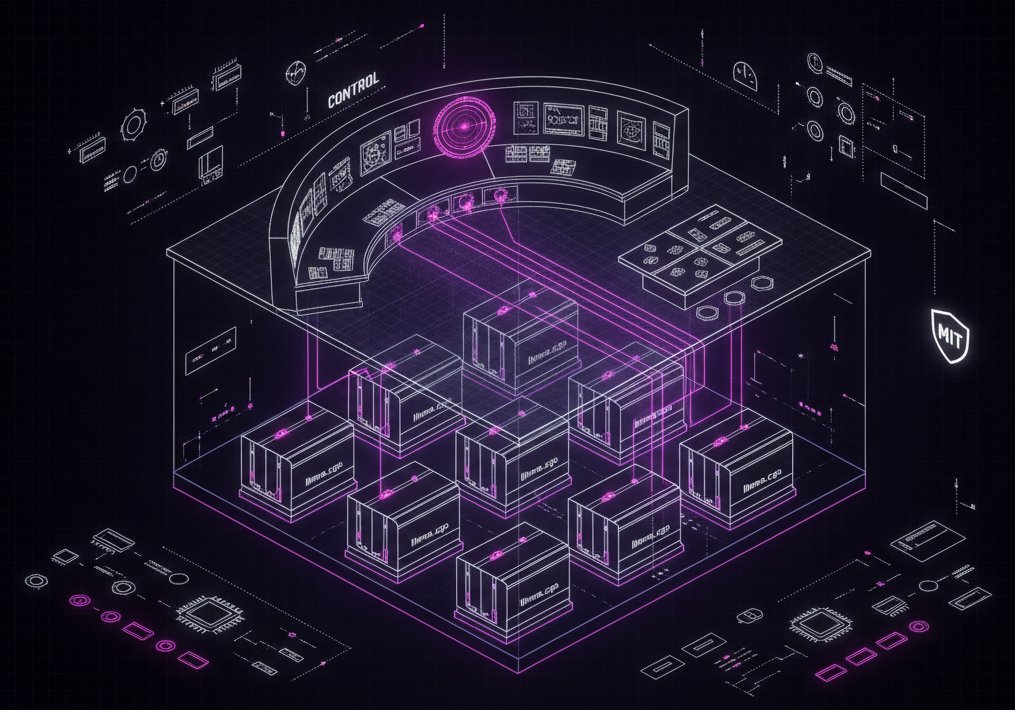
- 머신이 참여하는 세 가지 방법: VRAM/RAM/CPU 예산을 편집할 수 있는 고정 로컬 노드 슬롯; 다른 허브를 등록해 노드를 가져오는 원격 유닛; 그리고 평범한 요청/응답 HTTP로 참여하는 워커 전용 서비스 관리형 노드 에이전트 — 의도적으로 지속 스트림이 아니라서 단순한 LAN/VPN 라우팅에서도 살아남는다.
- 호환성 게이팅은 일급 개념: 모든 유닛·노드·에이전트가 프로토콜/런타임 팩 정체성과 백엔드 상세를 보고한다. 유닛·런타임 팩·추론엔진 리비전·RPC ABI 불일치는 bind/plan/load/infer 전에 하드 블록되고, 백엔드 차이(CUDA/Metal/Vulkan/CPU)는 거부가 아닌 capability로 추적된다.
- 플래너는 GGUF 메타데이터를 읽어 노드별 연속 레이어 배치,
--tensor-split, KV 캐시/레이어/전문가 VRAM 추정치, 그리고 선택적 전문가-FFN RAM offload를 만든다. - 게이트웨이: 모든 컨트롤러가 OpenAI 호환(
/v1/chat/completions,/v1/models)과 Anthropic 호환(/anthropic/v1/messages|models) 엔드포인트를 같은 로드된 모델로 노출한다 — 기존 클라이언트가 수정 없이 동작한다.
이 의도적 분리 — 소스 공개 컨트롤 플레인 아래의, 업스트림에 가깝게 유지된 데이터 플레인 — 가 이후 모든 것의 토대다: 링 런타임, 레이어 마켓, 그리고 결국 전문가 샤딩 스웜까지, 전부 같은 컴퓨트 위의 컨트롤 플레인 진화다.