Phase 3 — 백본 전문가 RAM Offload (M0)
MoE 전문가 FFN을 VRAM 대신 CPU RAM에서 스트리밍하면, 64 GB 코디네이터 한 대가 122B를 담는다 — 그래프 수술 없이.
전문가 FFN이 VRAM에 살아야 할 이유는 없다. CPU RAM에서 스트리밍하면 전문가가 VRAM을 초과하는 모델을 코디네이터 한 대가 담을 수 있다 — 약한 노드가 큰 MoE에 참여할 수 있게 하는 토대다.
플래너 검증 · 실제 122B GGUF
122B가 단일 64 GB 코디네이터에 들어간다
이전의 링은 가중치를 VRAM 전용으로 배치해 122B(77.6 GB)가 64 GB GCD에 infeasible이었다. 전문가-offload 규칙을 켜면 dry-run이 feasible로 돌아온다:
feasible
122B 링 플랜
62.6
VRAM GiB (≤ 64)
14.2
RAM GiB (전문가)
10
offload된 레이어
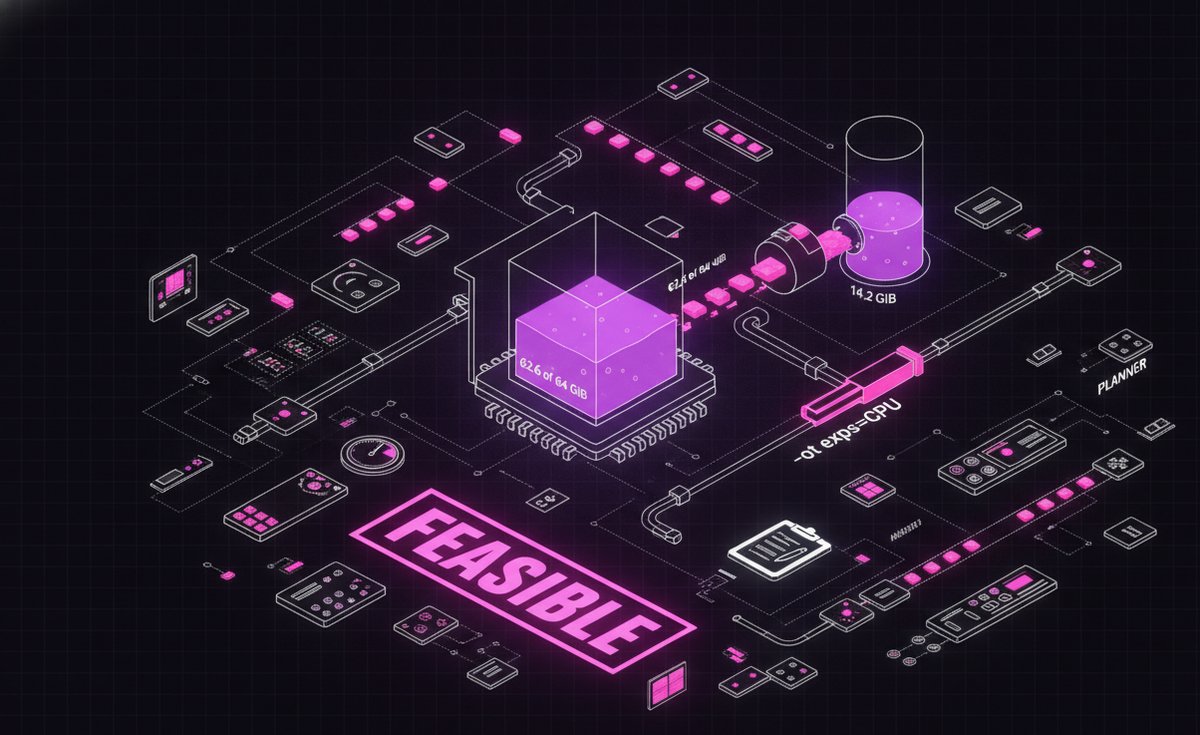
플래너 출력 — 추론엔진 -ot 규칙 형식.
node 0  layers [0,48]  vram=62.6  ram=14.2  ot_rules=10
sample: blk\.38\.ffn_(up|down|gate)_(ch|)exps=CPU   # inference engine -ot format
무엇을 배선했나 · 순수 Python, C++ 재빌드 없음
플래너의 offload 규칙을 실제 로드까지 나르기
- planner — 각 placement에 이미
ot(콤마 결합-ot규칙)를 생성. - protocol.py —
StageStartRequest.ot필드 추가. - runtime.py — placement의
ot를 스테이지 요청에 전달. - stage_service.py — 코디네이터가
--override-tensor로 실행. linkcpp-server는 미지의 인자를 기본 llama-server로 전달하므로-ot가 그대로 적용된다.
# stage_service.py — coordinator branch
if request.ot:
    command += ["--override-tensor", request.ot]
ot 프로토콜 왕복 테스트와 코디네이터 명령의 --override-tensor 방출 확인으로 검증했고, 허브는 회귀 없이 재배포됐다. 당시 남은 것: 전체 2-노드 77 GB 로드(offload 코디네이터 + ~1.5 GB 1-레이어 구간의 폰), 서버 가용성 대기. M0의 핵심 — 약한 노드가 큰 MoE에 참여하게 하는 백본 offload — 는 코드·플래너 수준에서 완결됐다.