Phase 5 — 분산 전문가 Dispatch (M2)
라이브 122B 디코드가 한 레이어의 전문가 계산을 TCP 너머 별도 워커 프로세스에 넘긴다 — 그리고 정확히 같은 토큰을 예측한다.
검증 · 실제 122B, 두 프로세스
백본 decode → TCP → 워커 → experts → 같은 토큰
MATCH
argmax OFF == ON (11751)
0.99869
로짓 cosine
0
전송 손실 (byte-identical)
2
프로세스 (백본 + 워커)
전문가 워커가 layer-0 슬라이스를 별도 프로세스(ROCm)로 서빙하고, 122B 백본의 build_moe_ffn dispatch 콜백이 (cur, sel)을 TCP로 보내 전문가 출력을 받는다. 로짓 cosine은 in-process 값과 정확히 같다(0.99868775) — 전송이 무손실이다. 전문가-병렬 스웜 계산이 프로세스 경계를 넘어 작동한다.
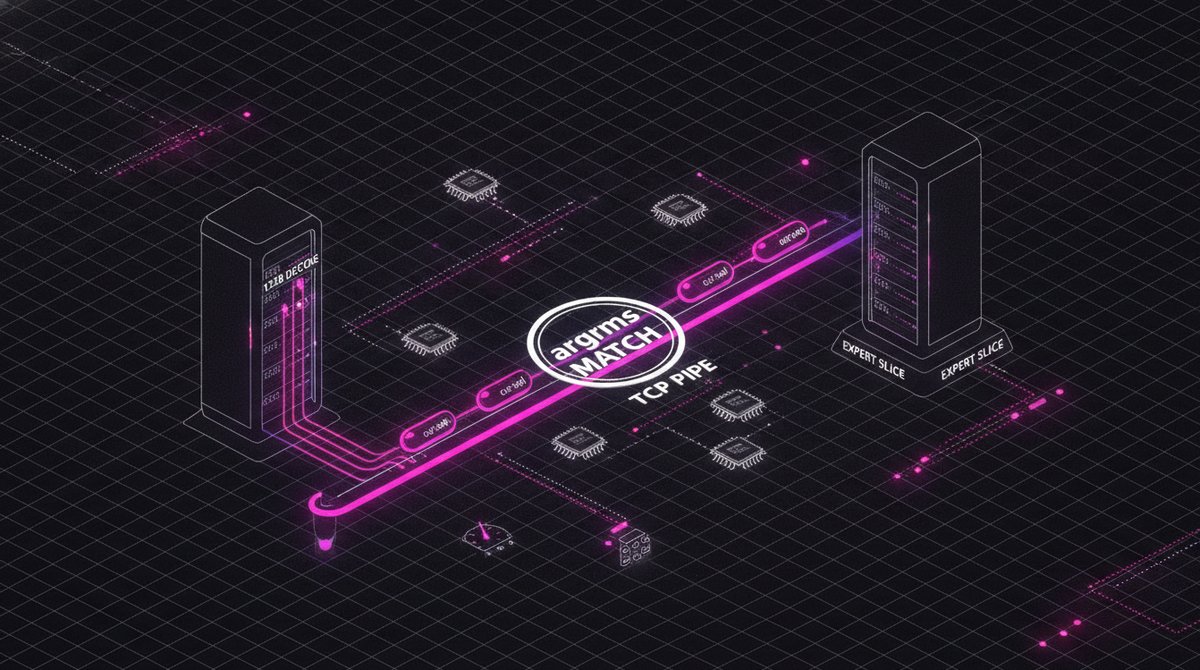
하나의 long-lived TCP 연결 — 링/443 릴레이가 터널링할 수 있는 바로 그 스트림.
# worker: serving as a separate process
linkcpp-expert-worker --serve 52700 --model L0_all.gguf --layer 0 --n-embd 3072
# backbone: build_moe_ffn callback dispatches to the worker
linkcpp-moe-verify 122B.gguf ... --dispatch-port 52700
  → protocol: [n_used, n_tokens] + cur + sel  →  experts
완료
분산 dispatch 파이프라인
--serve모드: 슬라이스 로드, TCP listen,(n_used, n_tokens, cur, sel) → experts응답.--dispatch-port: 백본 콜백이 in-process 계산 대신 별도 워커와 TCP로 송수신.- layer-0을 프로세스 밖으로 dispatch한 라이브 122B 디코드에서 실측 → argmax MATCH, cosine 0.99869(= in-process, 무손실).
- M2 코어(먼저): 폰의 ARM이 실제 122B 전문가를 cosine 0.99992로 계산(Android 크로스빌드).
다음 단계: 같은 TCP 스트림을 443 릴레이로 터널링해 다른 머신·폰의 워커로(전송은 링 작업에서 이미 검증됨), 그다음 M3 커버리지 마켓과 M4 배치 처리량.