Phase 7 — 배치 Dispatch 처리량 (M4)
스웜은 지연 게임이 아니라 처리량 패브릭이다: dispatch 호출을 배치로 묶으면 요청당 오버헤드가 토큰당 77배 상각된다.
실측 · ROCm, 전문가 FFN, n_used = 8
배치가 클수록 워커당 tok/s가 커진다
| 배치 | 워커당 tok/s |
|---|---|
| 1 | 688 |
| 16 | 4,255 |
| 64 | 8,130 |
| 256 | 30,666 |
| 512 | 53,067 |
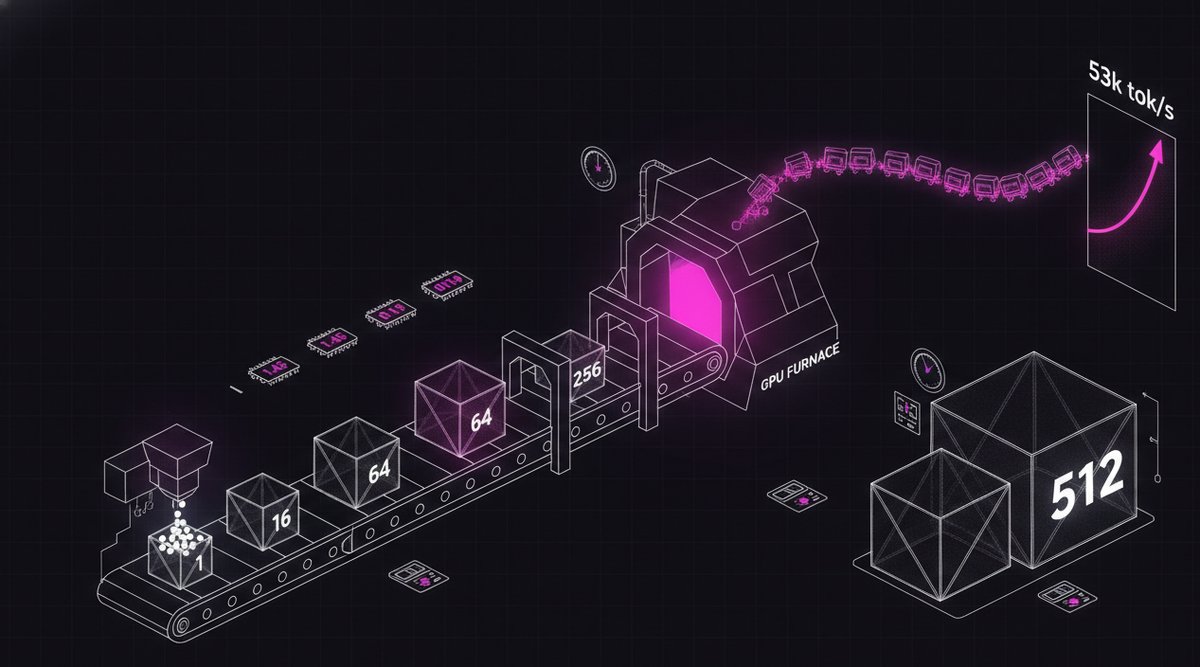
배치 1의 1.45 ms/tok에서 배치 512의 0.019 ms/tok으로 — 토큰당 77배 개선이다. 호출당 시간은 거의 그대로인데(1.45 → 9.6 ms) 배치는 512배로 커졌다 — GPU가 고정 오버헤드 뒤에서 배치를 거의 공짜로 처리한다. 이것이 expert-parallel을 실용화하는 처리량-패브릭 성질이다: 배치 dispatch가 요청당 RTT와 오버헤드를 상각한다.
완료
배치 dispatch 처리량
- 워커
--bench: 배치 1…512의 compute_dispatch 타이밍 → tok/s. - 배치 512(ROCm)에서 워커당 53k tok/s — 배치가 오버헤드를 상각.
- 이 위에 hot-expert 캐시와 다중 워커 집계 스케일링(복제본 라우팅)이 쌓인다.
M4로써 M0 → M4 전체 파이프라인이 실제 122B에서 실증됐다: 백본 offload · 전문가 슬라이스 · 검증된 워커 · 라이브 디코드 dispatch(argmax MATCH) · 분산 프로세스 · 커버리지 마켓 · 배치 처리량.