폰이 122B 추론에 참여했다
Galaxy S25가 허브에서 자기 전문가 슬라이스를 자율 다운로드하고, 라이브 122B 디코드의 매 스텝마다 한 레이어의 전문가를 계산했다. 출력은 정답이었다.
prompt: "The capital of France is" → 생성 결과(폰 참여): " Paris." — 로컬 실행과 8/8 토큰 동일.
실측 · 실제 122B, 폰이 layer-0 계산
정확성 + TPS
8/8
토큰 로컬과 동일
4.01
TPS 로컬 (기준)
3.13
TPS 폰 참여
1.58 GB
자율 다운로드
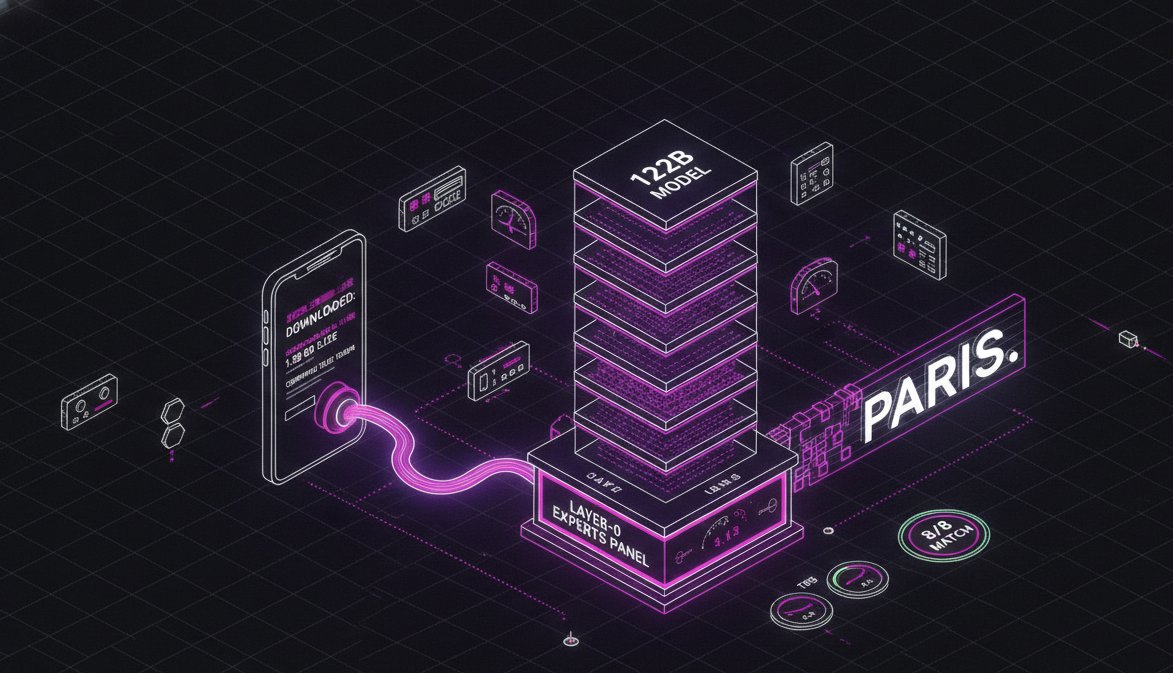
폰이 매 토큰마다 layer-0의 전문가를 계산해도 생성 토큰은 로컬과 완전히 동일 — 정답 "Paris."다. TPS는 4.01에서 3.13으로 떨어진다 — 폰 dispatch 왕복(MI250 → 터널 → 폰, 토큰당 ~100 ms)의 22% 비용이다. 처리량은 배치와 복제본으로 회복된다(M4).
자율 참여 흐름
탐색 → 보상 기반 다운로드 → 계산 참여
1. Phone knows the hub (hub.kvasir-ai.net — retired since; the bridge serves this)
2. GET /api/proxy/models/…/expert-shard?layers=0:1&experts=0:256
   # partially downloads its own expert slice (1.58 GB, WiFi)
3. linkcpp-expert-worker --serve
   # loads the slice (Adreno device, CPU backend) + waits for dispatch
4. MI250 backbone decodes the 122B → every token, layer-0 experts
   dispatch to the phone → experts return → combine → "Paris."
   (8/8 identical to local)
검증된 것 vs 남은 것
메커니즘은 완결, 앱 내 루프는 프로덕션화
- 부분 다운로드(expert-shard 엔드포인트), 워커 서빙, 백본 dispatch, 라이브 122B 생성과 TPS — 전부 실기기에서 검증.
- 정확성: 폰이 참여해도 8/8 토큰이 로컬 실행과 같고, 답도 정답.
- 남은 것: 앱 내 자율 루프(expert-demand 폴링 → volunteer → 다운로드 → serve → 등록)는 Kotlin 배선 — 이 데모는 메커니즘을 직접 구동했다.
- 전송: 이 데모는 SSH 터널을 썼고, 프로덕션은 443 릴레이를 쓴다(링 작업에서 이미 검증됨).