블루프린트에서 하드웨어까지: 검증된 것과 keystone
검증 캠페인의 회고 — 설계부터 M2 코어까지 실제 122B로 입증 — 그리고 나머지를 여는 단 하나의 통합 조각.
지난 몇 주간, 전문가 샤딩 스웜의 어렵고 새로운 조각들이 실제 Qwen3.5-122B에서 하나씩 입증됐다 — 시뮬레이션도, 장난감 크기도 아니다. 지금까지의 검증 궤적과, 마지막까지 남아 있던 단 하나의 keystone을 정리한다.
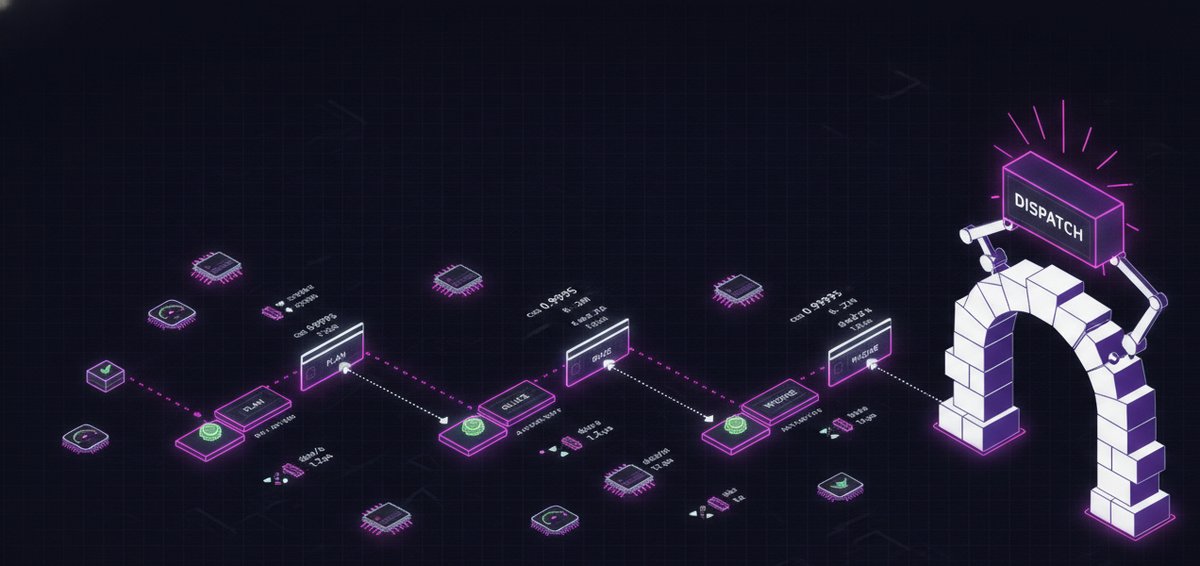
궤적 · 전부 실제 122B로 검증
지금까지 안착한 것들
- 설계(블루프린트 이후 5회 보강) — EP 아키텍처, 부분-가중치 자율 참여, 릴레이, 워커 커널 스펙, 그리고 교차 백엔드 수치 동등성을 핵심 기술로 문서화. 라우터 권위를 정합성 불변식으로 규정.
- M0 — 백본 전문가 RAM offload(플래너 검증): 122B가 단일 64 GB 코디네이터에 *feasible* — 전문가 10개 레이어를 RAM으로 offload, VRAM 62.6 GiB / RAM 14.2 GiB,
--override-tensor로 배선. - M1 — 전문가 슬라이스 데이터 경로: 전문가 단위 mini-GGUF 슬라이싱(ne[2] 슬랩, dequant 없는 바이트 복사) +
/expert-shard다운로드 엔드포인트. - M1 — 수치 oracle: 실제 layer-0 전문가에서 dispatch + combine == monolithic, max|Δ| = 3.6e-12 — 샤딩은 같은 가중합의 정확한 재그룹핑.
- M1 — C++ 워커 하드웨어 검증:
linkcpp-expert-worker(순수 ggml/gguf)를 ROCm에서 빌드·실행, oracle 대비 cosine 0.99995; router → C++ 워커 2개 → combine이 monolithic과 cosine 0.9997–0.9999로 일치. - M2 코어 — 폰이 실제 122B 전문가 계산: Android 크로스빌드, SM-S938N에서 실행, oracle 대비 cosine 0.99992.
- 수치 — 3-백엔드 동등성 행렬: 같은 122B 계산을 ROCm × 폰 ARM CPU × numpy로 — ROCm↔폰 cosine 0.99990, ROCm↔numpy 0.99996, 폰↔numpy 0.99992. 모두 동등, 어느 것도 bit-identical 아님.
keystone
live decode 안으로 통합되는 백본 dispatch
모든 구성요소 — 슬라이스, 워커, dispatch/combine 로직, 수치 동등성, 폰 계산 — 가 실기기 검증됐다. 남은 것은 이들을 실제 추론엔진 decode 안에서 연결하는 것: 그래프 중간에서 전문가를 소유 노드로 dispatch하는 build_moe_ffn 훅이다. 핀 고정된 추론엔진 서브모듈 수정과 여러 번의 빌드-검증 사이클이 필요했다. 이 keystone이 서면 M2 릴레이 통합, M3 전문가 커버리지 마켓, M4 배치 처리량이 차례로 열린다 — 모두 이 dispatch에 의존한다.
keystone은 그 후 안착했다: M2·M3·M4와 라이브 폰 데모 후속 글들이 바로 이 통합의 결과물이다.