Zwerm-inferentie met expert-sharding: het ontwerp
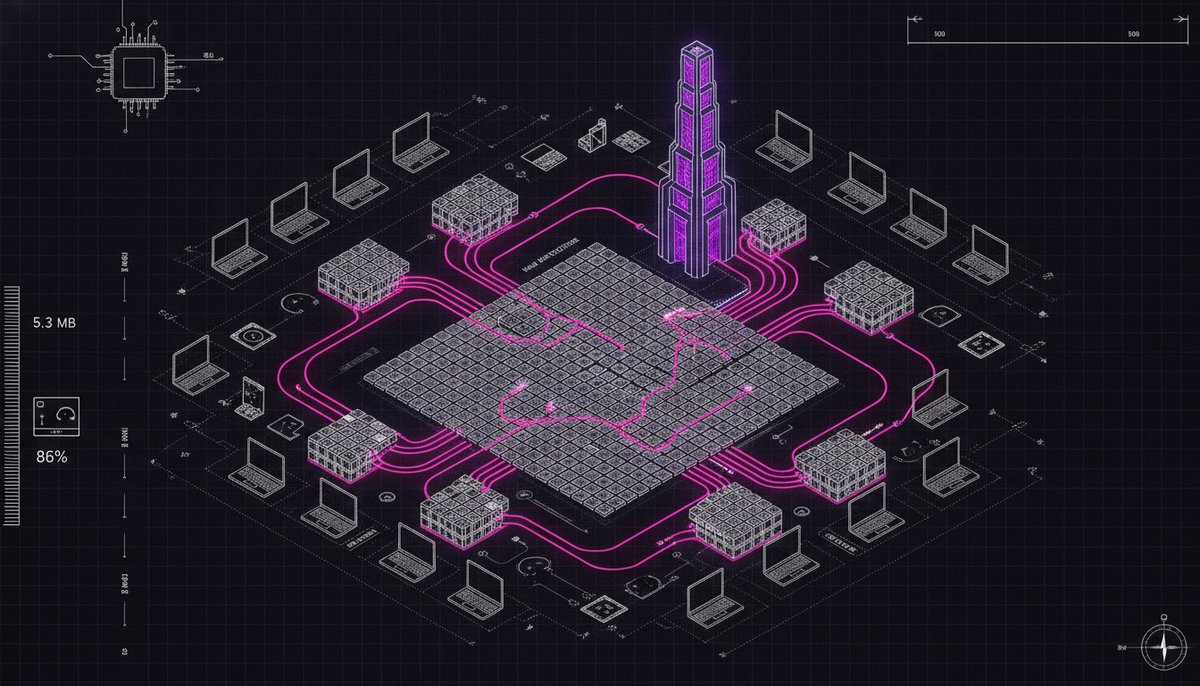
86% van een 122B-MoE bestaat uit 12.544 onafhankelijke experts van 5.3 MB. Snijd het model op die korrel en een telefoon draagt een echt aandeel van frontier-inferentie.
De these: 86% van het gewicht van Qwen3.5-122B bestaat uit 12.544 onderling onafhankelijke experts van 5.3 MB. Shard op de expertkorrel en een zwak apparaat draagt "8–64 experts (42–340 MB)" in plaats van "een laag van 1.4 GB" — precies de eenheid die een telefoon werkelijk kan vasthouden. MoE is het natuurlijke substraat van een zwerm.
De gewichten zijn al verpakt in zwermformaat
De expertindex is de buitenste dimensie van elke MoE-tensor, dus elke expert is een aaneengesloten, kwantblok-uitgelijnde plaat. Een expert-gesneden mini-GGUF is een schone byte-range-kopie — geen dekwantisatie, geen herverpakking.
Backbone-stage × expert-worker
- Backbone-stage (sterke node): attention + KV-cache, alle norms, de router, de gedeelde expert en de residual combine — het hele dichte pad. Hij houdt bovendien alle experts resident als fallback-replica (RAM-offload), wat de zwerm churn-tolerantie geeft.
- Expert-worker (een telefoon): geen transformer. Geen attention, geen KV, geen sampler — een pure functie
(hidden, local_ids) → outvan drie mat-muls, die alleen zijn eigen expertplak huisvest. Past in elk budget, tot een telefoon van 4 GB.
Het snijpunt: de router draait één keer op de backbone, met autoriteit.
cur   = ffn_norm(x)                       # backbone
ids,p = top_k(softmax(cur @ router), 8)   # backbone — authoritative
── dispatch selected experts to owner nodes ──
send  (cur rows, local_ids)  →  worker    # ~6 KB per decode step
recv  expert_out             ←  worker
x = x + combine(p, partials) + shared(cur)  # backbone — numerically exact
Omdat de router precies één keer op de backbone draait, wordt elke geselecteerde expert precies één keer berekend door de node die hem bezit. Er is geen benadering — sharding verplaatst alleen waar de mat-muls gebeuren.
De zwerm is de bewezen beloningsmarkt, fijner gekorreld
Kvasir draait al een autonome schaarstemarkt voor laag-shards, geverifieerd op echte apparaten: een telefoon achter NAT pollt de vraagkaart, schrijft zichzelf in op het hoogst belonende segment, downloadt alleen dat venster gedeeltelijk, laadt het op zijn Adreno-GPU en voltooit ringinferentie — en verdient bijdragebeloningen. Expert-sharding hergebruikt dat alles — dekkingskaart, zelfinschrijving op maximale beloning, gedeeltelijke download, beloningen per node — en verandert alleen de dekkingseenheid van *laagbereiken* naar *(laag, expertbereik)*.
Deelname met deelgewichten + de 443-relay
- Beloningsgedreven gedeeltelijke gewichtsdownload: conventionele RPC/TP/PP-opstellingen sturen de volledige checkpoint naar elke rank en een scheduler dicteert de plaatsing. Bij Kvasir downloadt een node alleen de plak die hij gaat berekenen, en kiest die plak zelf, op beloning — een stage-mini-GGUF van 254 MB tegenover het volledige model van 77.6 GB. Zo sluit een telefoon van 4 GB zich aan bij een model dat veel groter is dan hijzelf.
- 443-relay-datavlak: Cloudflares 80/443-only edge plus carrier-NAT betekent geen directe verbinding in beide richtingen. Een WebSocket-brug per edge met een 1-byte rol-preamble laat beide kanten naar buiten bellen (de telefoon opent nul inkomende poorten). De landing vergde drie echte bugfixes — build-fingerprint-overeenstemming, node-token-downloadauthenticatie, en een Kotlin
Int.ushr-framelengtebug die elk frame ≥ 64 KiB stilletjes beschadigde (ushrgebruikt alleen de laagste 5 bits van de shift;len ushr 56werdlen ushr 24) — opgelost metLong-shifts.
Een doorvoerweefsel, geen lagelatentie-decoder
Decoderen is 49 seriële lagen, en één internet-rondreis per laag kost 2.5–10 s per token. De wedstrijd van de zwerm is dus modellen serveren die niemand alleen kan hosten, gemeten in totale doorvoer: batch-dispatch amortiseert de RTT, de backbone houdt een hot-expert-cache, en verzoeken routeren naar nabije replica's. Het lagelatentiepad blijft bij de pipeline-ring.
M0 → M4
- M0 — backbone-expert-RAM-offload: draai de 122B op één coördinator, zonder graafchirurgie.
- M1 — expert-parallel bewijs op één host: expert-gesneden mini-GGUF + worker-runtime + dispatch, logits exact gelijk aan monolithisch.
- M2 — LAN- + NAT-telefoonworkers die echte 122B-experts berekenen door de 443-relay.
- M3 — dekkingsmarkt op expertkorrel met replica's en churn-fallback.
- M4 — doorvoer: batch-dispatch + hot-expert-cache, tokens/s schalend met het aantal workers.