Phase 2 — Binnenin een 122B-MoE: waarom de gewichten geshard willen worden
Een analyse op tensorniveau van Qwen3.5-122B: 86% van de bytes zijn 12.544 onafhankelijke expertplaten, elk één schone byte-range-kopie verwijderd van zelfstandigheid.
Voordat we iets ontwierpen, haalden we de 122B op schijf uit elkaar. De vraag: als een zwerm zwakke apparaten dit model moet dragen, wat is dan de natuurlijke draageenheid? Het antwoord viel uit de GGUF-tensorlayout zelf.
Waar een MoE-laag werkelijk uit bestaat
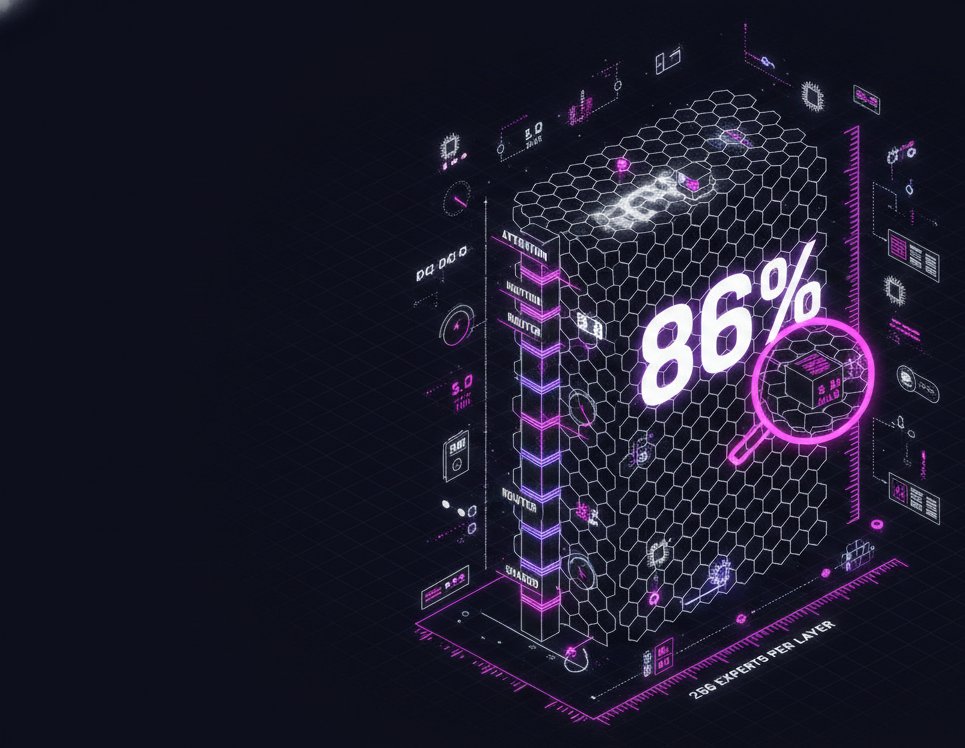
Elke laag splitst in een dicht pad — attention + KV, de norms, de router (ffn_gate_inp), een gedeelde expert — en een expertbank: 256 onafhankelijke FFN's opgeslagen als drie gestapelde tensoren (ffn_up_exps, ffn_gate_exps, ffn_down_exps). Het dichte pad is de minderheid van de bytes; de expertbank is 86% van het model.
Experts zijn aaneengesloten, blok-uitgelijnde platen
- De expertindex is de buitenste ggml-dimensie (
ne[2]) van elke experttensor — expert *e* beslaat één aaneengesloten, kwantblok-uitgelijnde plaat rauwe gekwantiseerde bytes. - Dat maakt extractie per expert een byte-range-kopie:
data[a:b], geen dekwantisatie, geen herverpakking — een expert-gesneden mini-GGUF is goedkoop te maken en bit-getrouw. - Per token vuren slechts 8 van de 256 experts per laag, gekozen door de router — het expertverkeer van een laag bij decoderen is dus een handvol kleine matrixvermenigvuldigingen over één hidden-vector.
De draageenheid daalt van 1.4 GB naar 5.3 MB
Op laagkorrel is het minste dat een node kan houden ~1.4 GB — buiten bereik van de meeste telefoons zodra app, KV en OS hun deel nemen. Op expertkorrel is de eenheid 5.3 MB, en een realistische bijdrage is 8–64 experts (42–340 MB) — ruim binnen elk modern apparaat. De experts zijn onderling onafhankelijk, dus eigendom kan willekeurig verspreid en vrij herverdeeld worden. Deze analyse maakte sharding op expertniveau tot de ontwerpgok: de gewichten waren al verpakt in zwermformaat — het netwerk hoefde de verpakking alleen te eren.