Phase 3 — Backbone-expert-RAM-offload (M0)
Stream MoE-expert-FFN's uit CPU-RAM in plaats van VRAM, en één coördinator van 64 GB houdt een 122B vast — zonder graafchirurgie.
Expert-FFN's hoeven niet in VRAM te wonen. Ze uit CPU-RAM streamen laat één coördinator een model vasthouden waarvan de experts zijn VRAM overstijgen — het fundament dat zwakke nodes überhaupt aan een grote MoE laat deelnemen.
Een 122B past op één coördinator van 64 GB
Voorheen plaatste de ring gewichten alleen in VRAM, dus de 122B (77.6 GB) was infeasible op een 64-GB-GCD. Met expert-offload-regels komt de dry-run feasible terug:
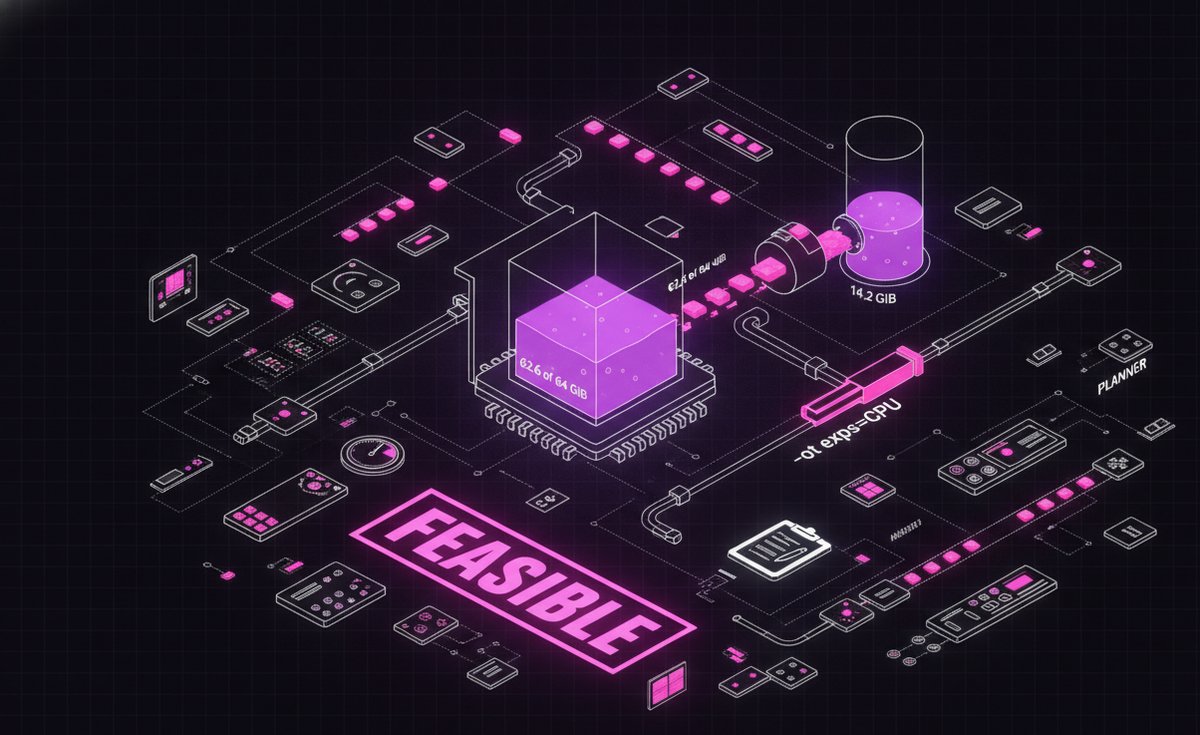
Planner-uitvoer — inferentie-engine -ot-regelformaat.
node 0  layers [0,48]  vram=62.6  ram=14.2  ot_rules=10
sample: blk\.38\.ffn_(up|down|gate)_(ch|)exps=CPU   # inference engine -ot format
De offload-regels van de planner naar een echte load dragen
- planner — zendt al
ot(komma-gevoegde-ot-regels) uit in elke plaatsing. - protocol.py — veld
StageStartRequest.ottoegevoegd. - runtime.py — stuurt de
otvan de plaatsing door naar het stage-verzoek. - stage_service.py — de coördinator start met
--override-tensor. linkcpp-servergeeft onbekende argumenten door aan de standaard llama-server, dus-otgrijpt ongewijzigd aan.
# stage_service.py — coordinator branch
if request.ot:
    command += ["--override-tensor", request.ot]
Geverifieerd met een ot-protocol-rondreistest plus de bevestiging dat het coördinatorcommando --override-tensor uitzendt; de hub herdeployde schoon zonder regressies. Wat toen restte: de volledige 2-node-77-GB-load (coördinator met offload + een telefoon met een ~1.5-GB-éénlaagsvenster), wachtend op serverbeschikbaarheid. De kern van M0 — de backbone-offload die zwakke nodes aan een grote MoE laat deelnemen — was op code- en plannerniveau compleet.