Phase 5 — Gedistribueerde expert-dispatch (M2)
Een live 122B-decodering geeft de expertberekening van één laag via TCP aan een apart workerproces — en voorspelt exact hetzelfde token.
Backbone-decodering → TCP → worker → experts → hetzelfde token
De expert-worker serveert de layer-0-plak als apart proces (ROCm), en de build_moe_ffn-dispatch-callback van de 122B-backbone verstuurt (cur, sel) over TCP en ontvangt de expertuitvoer. De logit-cosine is exact de in-process-waarde (0.99868775) — het transport is verliesloos. Expert-parallelle zwermberekening werkt over een procesgrens heen.
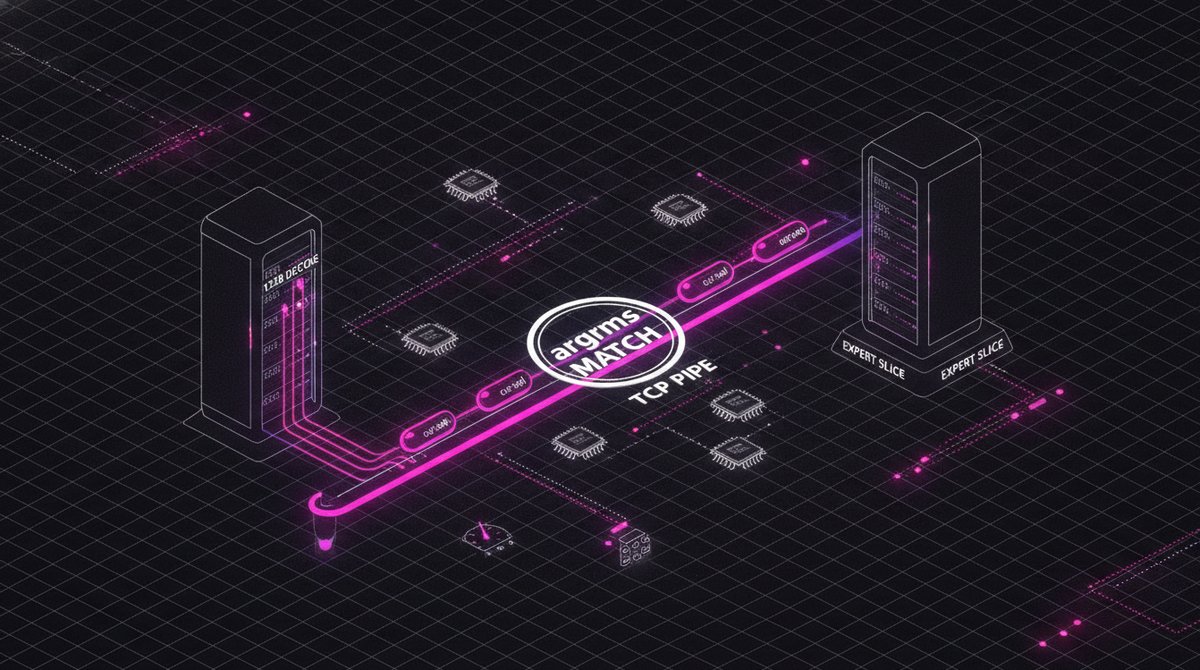
Eén langlevende TCP-verbinding — dezelfde stream die ring/443-relay kunnen tunnelen.
# worker: serving as a separate process
linkcpp-expert-worker --serve 52700 --model L0_all.gguf --layer 0 --n-embd 3072
# backbone: build_moe_ffn callback dispatches to the worker
linkcpp-moe-verify 122B.gguf ... --dispatch-port 52700
  → protocol: [n_used, n_tokens] + cur + sel  →  experts
De gedistribueerde dispatch-pipeline
--serve-modus: laad de plak, luister op TCP, beantwoord(n_used, n_tokens, cur, sel) → experts.--dispatch-port: de backbone-callback zendt/ontvangt via TCP naar een aparte worker, ter vervanging van in-process-berekening.- Gemeten op een live 122B-decodering met layer-0 buiten het proces gedispatcht → argmax MATCH, cosine 0.99869 (= in-process, verliesloos).
- M2-kern (eerder): de ARM van de telefoon berekende echte 122B-experts op cosine 0.99992 (Android-crossbuild).
Hierna: dezelfde TCP-stream door de 443-relay tunnelen naar workers op andere machines en telefoons (het transport is al bewezen in het ringwerk), dan de M3-dekkingsmarkt en M4-batchdoorvoer.