Phase 7 — Batch-dispatch-doorvoer (M4)
De zwerm is een doorvoerweefsel, geen latentiespel: dispatch-aanroepen bundelen amortiseert de overhead per verzoek 77× per token.
Gemeten · ROCm, expert-FFN, n_used = 8
Grotere batches, meer tok/s per worker
| batch | tok/s per worker |
|---|---|
| 1 | 688 |
| 16 | 4,255 |
| 64 | 8,130 |
| 256 | 30,666 |
| 512 | 53,067 |
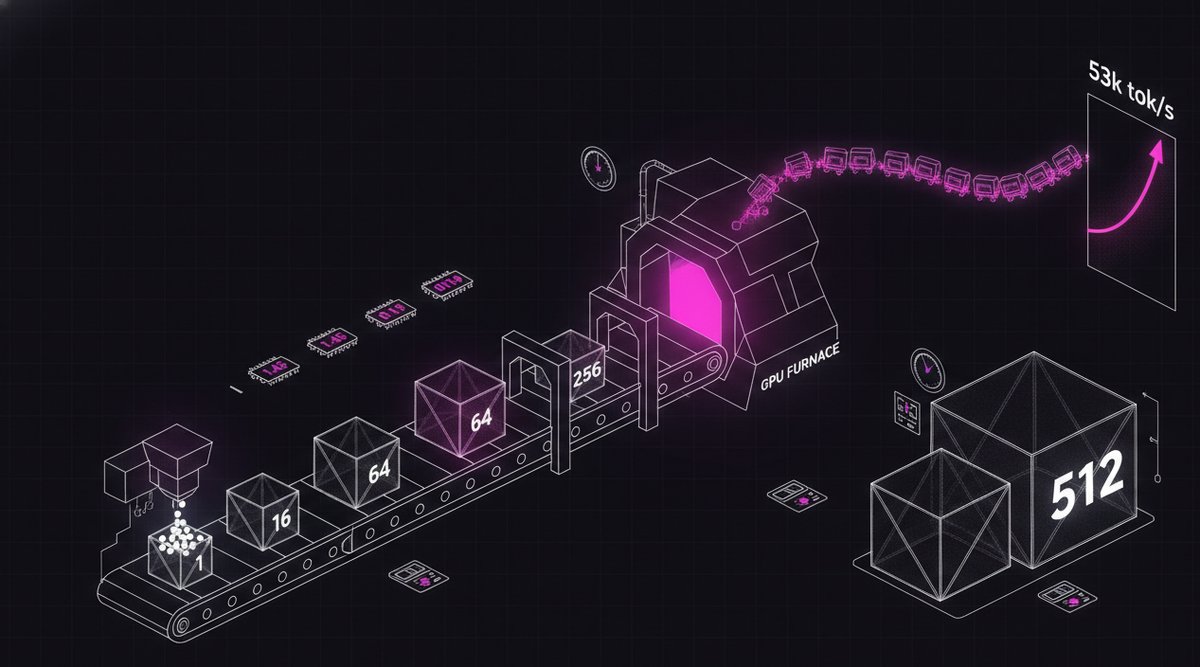
Van 1.45 ms/tok bij batch 1 naar 0.019 ms/tok bij batch 512 — een verbetering van 77× per token. De tijd per aanroep beweegt nauwelijks (1.45 → 9.6 ms) terwijl de batch 512× groeit — de GPU verwerkt de batch bijna gratis achter een vaste overhead. Dit is de doorvoerweefsel-eigenschap die expert-parallel praktisch maakt: batch-dispatch amortiseert RTT en overhead per verzoek.
Klaar
Batch-dispatch-doorvoer
- Worker
--bench: compute_dispatch-timings voor batch 1…512 → tok/s. - 53k tok/s per worker bij batch 512 (ROCm) — bundelen amortiseert de overhead.
- Hierbovenop stapelen hot-expert-caching en multi-worker-aggregaatschaling (replica-routering).
Met M4 is de hele M0 → M4-pipeline gedemonstreerd op een echte 122B: backbone-offload · expertplakken · geverifieerde workers · live decode-dispatch (argmax MATCH) · gedistribueerde processen · dekkingsmarkt · batchdoorvoer.