Een telefoon deed mee aan 122B-inferentie
Een Galaxy S25 downloadde autonoom zijn expertplak van de hub en berekende bij elke stap van een live 122B-decodering de experts van één laag. De uitvoer was correct.
prompt: "The capital of France is" → gegenereerd (met de telefoon in de lus): " Paris." — 8/8 tokens identiek aan de lokale run.
Gemeten · echte 122B, telefoon berekent layer-0
Correctheid + TPS
8/8
tokens identiek aan lokaal
4.01
TPS lokaal (basislijn)
3.13
TPS met telefoon
1.58 GB
autonome download
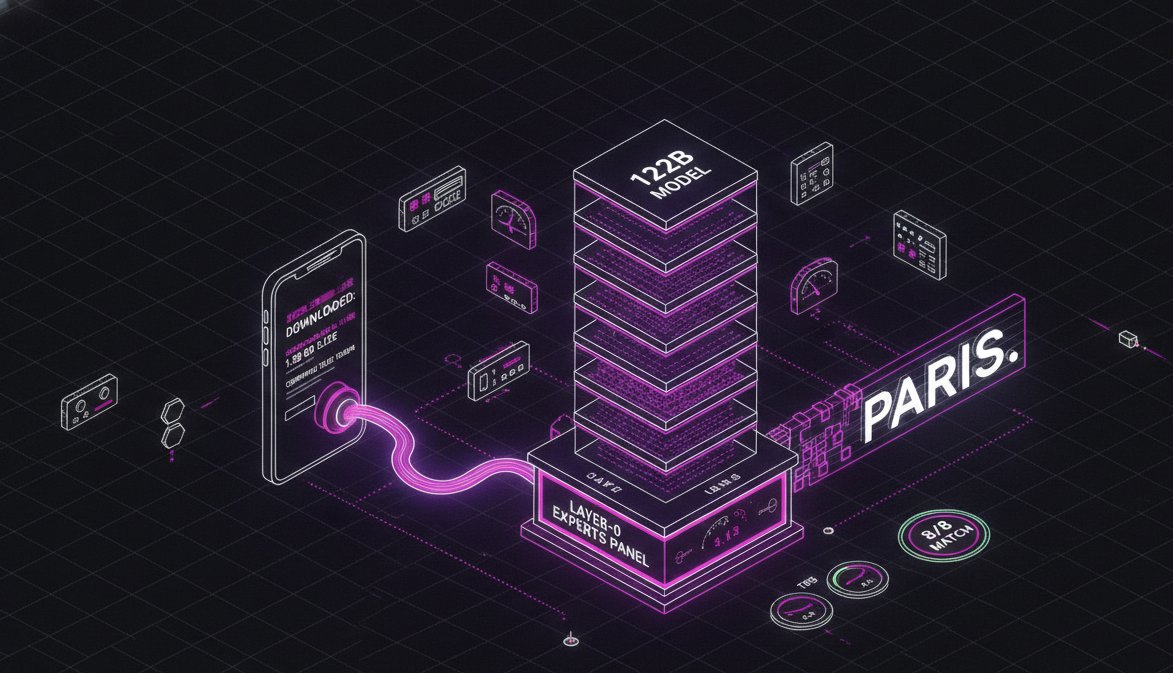
Zelfs met de telefoon die voor elk token de layer-0-experts berekent, zijn de gegenereerde tokens exact de lokale — het juiste "Paris.". De TPS zakt van 4.01 naar 3.13 — de telefoon-dispatch-rondreis (MI250 → tunnel → telefoon, ~100 ms/token) kost 22%. De doorvoer komt terug met batching en replica's (M4).
De autonome deelnamestroom
Ontdekken → beloningsgedreven download → meedoen aan de berekening
1. Phone knows the hub (hub.kvasir-ai.net — retired since; the bridge serves this)
2. GET /api/proxy/models/…/expert-shard?layers=0:1&experts=0:256
   # partially downloads its own expert slice (1.58 GB, WiFi)
3. linkcpp-expert-worker --serve
   # loads the slice (Adreno device, CPU backend) + waits for dispatch
4. MI250 backbone decodes the 122B → every token, layer-0 experts
   dispatch to the phone → experts return → combine → "Paris."
   (8/8 identical to local)
Geverifieerd vs resterend
Het mechanisme is compleet; de in-app-lus is productisering
- Gedeeltelijke download (het expert-shard-endpoint), worker-serving, backbone-dispatch, live 122B-generatie en TPS — allemaal geverifieerd op het echte apparaat.
- Correctheid: met de telefoon in de lus zijn 8/8 tokens gelijk aan de lokale run, met het juiste antwoord.
- Resterend: de autonome in-app-lus (expert-demand pollen → volunteer → downloaden → serve → registreren) is Kotlin-bedrading — deze demo dreef het mechanisme direct aan.
- Transport: deze demo gebruikte een SSH-tunnel; productie gebruikt de 443-relay (al geverifieerd in het ringwerk).