Van blauwdruk naar hardware: het geverifieerde, en de sluitsteen
Een terugblik op de verificatiecampagne — ontwerp tot en met M2-kern bewezen op een echte 122B — en het ene integratiestuk dat de rest ontgrendelt.
De afgelopen weken werden de moeilijke, nieuwe onderdelen van de expertzwerm één voor één bewezen op een echte Qwen3.5-122B — niet gesimuleerd, geen speelgoedformaat. Hier is het verificatiespoor tot nu toe, en de ene sluitsteen die overbleef.
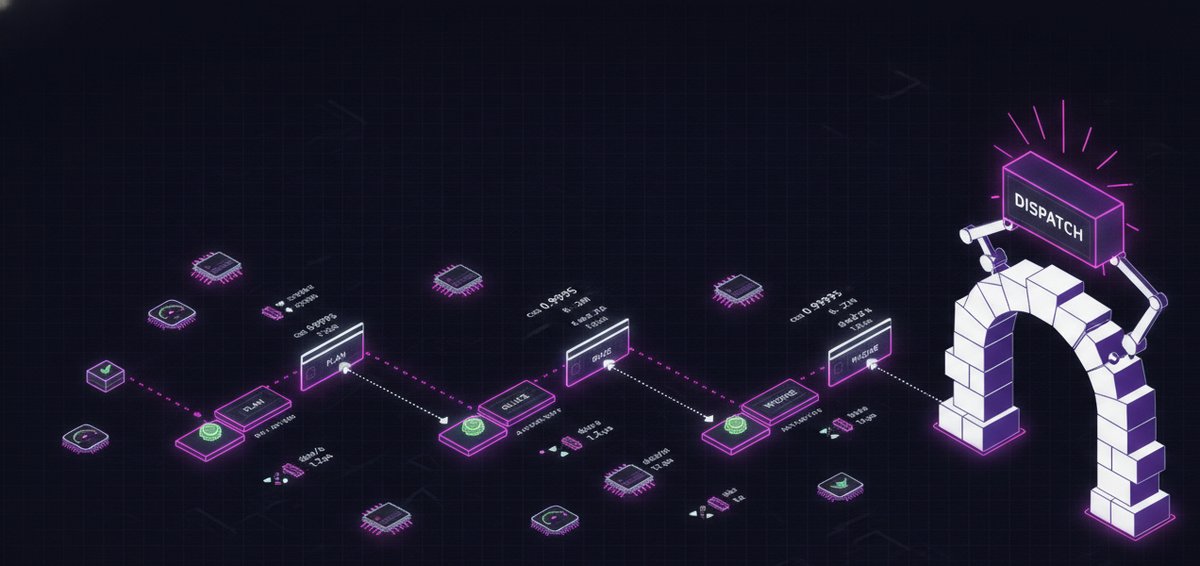
Wat er al is geland
- Ontwerp (5 revisies sinds de blauwdruk) — EP-architectuur, autonome deelname met deelgewichten, de relay, de worker-kernelspecificatie, en cross-backend numerieke equivalentie gecodificeerd als kerntechnologie. Router-autoriteit vastgelegd als de coherentie-invariant.
- M0 — backbone-expert-RAM-offload (planner geverifieerd): de 122B is *feasible* op één coördinator van 64 GB — 10 expertlagen naar RAM geoffload, VRAM 62.6 GiB / RAM 14.2 GiB, bedraad via
--override-tensor. - M1 — expertplak-datapad: mini-GGUF-slicing per expert (ne[2]-platen, bytekopie zonder dekwantisatie) + het
/expert-shard-downloadendpoint. - M1 — numeriek orakel: dispatch + combine == monolithisch met max|Δ| = 3.6e-12 op echte layer-0-experts — sharding is een exacte hergroepering van dezelfde gewogen som.
- M1 — C++-worker op hardware:
linkcpp-expert-worker(puur ggml/gguf) gebouwd en gedraaid op ROCm, cosine 0.99995 vs het orakel; router → twee C++-workers → combine evenaart monolithisch op cosine 0.9997–0.9999. - M2-kern — een telefoon berekent echte 122B-experts: Android-crossbuild, gedraaid op een SM-S938N, cosine 0.99992 vs het orakel.
- Numeriek — 3-backend-equivalentiematrix: dezelfde 122B-berekening op ROCm × telefoon-ARM-CPU × numpy — ROCm↔telefoon cosine 0.99990, ROCm↔numpy 0.99996, telefoon↔numpy 0.99992. Alles equivalent, niets bit-identiek.
Backbone-dispatch, geïntegreerd in live decoderen
Elk onderdeel — plakken, workers, dispatch/combine-logica, numerieke equivalentie, telefoonberekening — was apparaat-geverifieerd. Wat restte was ze binnen een echte inferentie-engine-decodering te bedraden: een build_moe_ffn-hook die experts midden in de graaf naar hun eigenaarnodes dispatcht. Dat vergde aanpassing van de vastgepinde inferentie-engine-submodule en meerdere build-verify-cycli. Zodra deze sluitsteen staat, openen M2-relay-integratie, de M3-expertdekkingsmarkt en M4-batchdoorvoer zich achtereenvolgens — ze hangen allemaal van deze dispatch af.
De sluitsteen is inmiddels geland: de vervolgposts over M2, M3, M4 en de live telefoondemostratie zijn de resultaten van precies deze integratie.