专家分片蜂群推理:设计
一个 122B MoE 的 86% 是 12,544 个相互独立的 5.3 MB 专家。按这个颗粒切分模型,手机也能承担前沿推理的真实份额。
论点:Qwen3.5-122B 权重的 86% 是 12,544 个相互独立的 5.3 MB 专家。按专家颗粒分片,弱设备背负的就不是"一个 1.4 GB 的层",而是"8–64 个专家(42–340 MB)"——恰好是手机真正能承受的单位。MoE 是蜂群的天然基质。
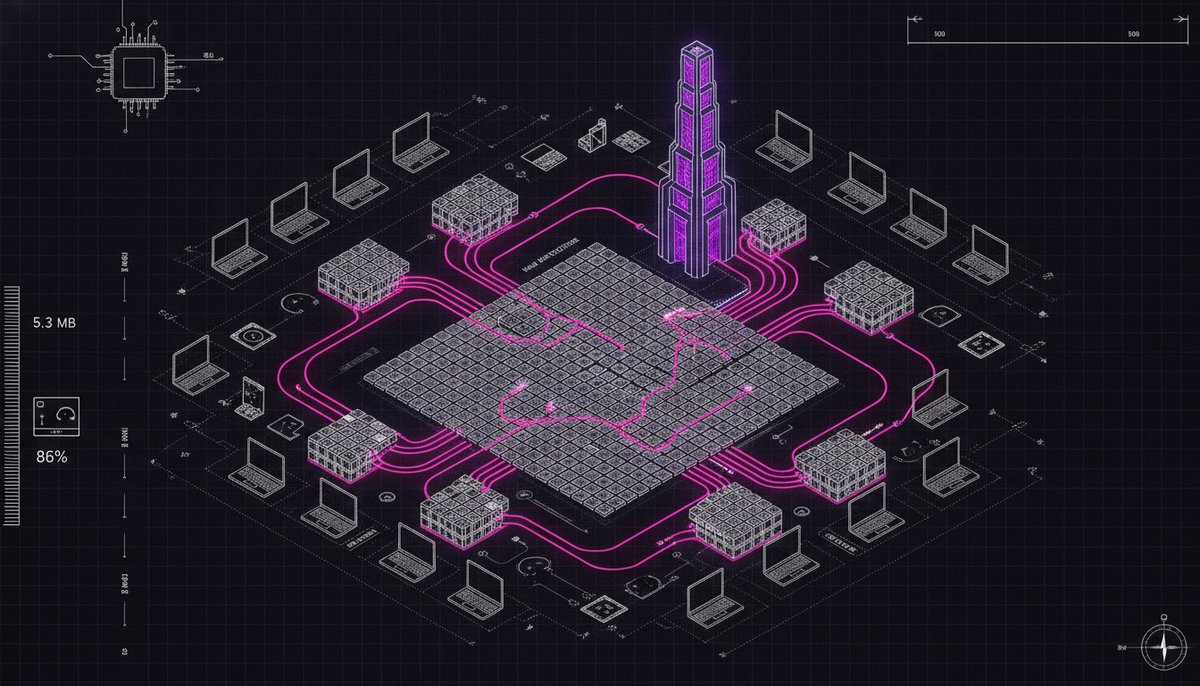
基质 · Qwen3.5-122B-A10B (Q4_K_M)
权重出厂时就已打包成蜂群大小的单位
49
层
256
专家 / 层
8
每 token 激活
5.3 MB
单个专家 (Q4)
12,544
专家总数
86%
权重中专家占比
3072
n_embd
ne[2]
专家维 = 最外层
专家索引是每个 MoE 张量的最外层维度,因此每个专家都是一块连续、量化块对齐的板块。按专家切片的 mini-GGUF 就是一次干净的字节范围拷贝——无需反量化,无需重新打包。
两个角色
骨干 stage × 专家 worker
- 骨干 stage(强节点):注意力 + KV 缓存、所有 norm、路由器、共享专家、residual combine——整条稠密路径。它还把所有专家作为后备副本常驻(RAM 卸载),赋予蜂群抗流失能力。
- 专家 worker(手机):不是 transformer。没有注意力、没有 KV、没有采样器——只是纯函数
(hidden, local_ids) → out,由三次矩阵乘构成,只常驻自己的专家切片。任何预算都装得下,低至 4 GB 手机。
切分点:路由器只在骨干上带权威地运行一次。
cur   = ffn_norm(x)                       # backbone
ids,p = top_k(softmax(cur @ router), 8)   # backbone — authoritative
── dispatch selected experts to owner nodes ──
send  (cur rows, local_ids)  →  worker    # ~6 KB per decode step
recv  expert_out             ←  worker
x = x + combine(p, partials) + shared(cur)  # backbone — numerically exact
由于路由器在骨干上恰好运行一次,每个被选中的专家由持有它的节点恰好计算一次。没有任何近似——分片只是移动了矩阵乘发生的位置。
不是新的子系统
蜂群 = 已验证的奖励市场,只是颗粒更细
Kvasir 已经为层分片运行着一套自治稀缺性市场,并在真机上验证过:NAT 后的手机轮询需求图,自助报名最高奖励的区段,只部分下载那个窗口,加载到 Adreno GPU,跑完环推理——并赚到贡献奖励。专家分片全盘复用这一切——覆盖图、最高奖励自助报名、部分下载、按节点奖励——只把覆盖单位从*层区间*换成*(层, 专家范围)*。
两项已在真机验证的创新
部分权重参与 + 443 中继
- 奖励驱动的部分权重下载:传统 RPC/TP/PP 把完整检查点发给每个 rank,由调度器指定放置。在 Kvasir 中,节点只下载自己要计算的切片,且自己按奖励挑选切片——254 MB 的 stage mini-GGUF 对比 77.6 GB 的完整模型。这就是 4 GB 手机加入远大于自身的模型的机制。
- 443 中继数据平面:Cloudflare 只放行 80/443 的边缘加上运营商 NAT,意味着两个方向都无法直连。带 1 字节 role preamble 的每边缘 WebSocket 桥让双方都向外拨号(手机开放的入站端口为零)。落地过程中修了三个真实 bug——构建指纹一致性、node-token 下载鉴权,以及静默损坏所有 ≥ 64 KiB 帧的 Kotlin
Int.ushr帧长 bug(ushr只取移位量低 5 位,len ushr 56变成len ushr 24)——改用Long移位修复。
诚实的关键点
是吞吐织物,不是低延迟解码器
解码是 49 层串行,每层一次跨互联网往返意味着每 token 2.5–10 秒。因此蜂群的赛场是共同服务没人能独自托管的模型,以总吞吐衡量:批量调度摊销 RTT,骨干维护 hot-expert 缓存,请求路由到就近副本。低延迟路径仍由流水线环负责。
路线图
M0 → M4
- M0 — 骨干专家 RAM 卸载:单台协调器运行 122B,无需图手术。
- M1 — 单主机专家并行证明:专家切片 mini-GGUF + worker 运行时 + 调度,logits 与整体完全一致。
- M2 — LAN + NAT 手机 worker 通过 443 中继计算真实 122B 专家。
- M3 — 带副本与流失回退的专家颗粒覆盖市场。
- M4 — 吞吐:批量调度 + hot-expert 缓存,tokens/s 随 worker 数扩展。