Phase 2 — 122B MoE 解剖:权重为何想被分片
Qwen3.5-122B 的张量级分析:86% 的字节是 12,544 个独立专家板块,每一块离独立存在只差一次干净的字节范围拷贝。
在设计任何东西之前,我们先把 122B 在磁盘上拆开。问题是:如果要让一群弱设备背起这个模型,天然的承载单位是什么?答案从 GGUF 张量布局本身掉了出来。
解剖 · Qwen3.5-122B-A10B (Q4_K_M)
MoE 的一层究竟由什么构成
49
层
256
专家 / 层
8
每 token 激活
12,544
专家总数
5.3 MB
单个专家 (Q4)
86%
权重中专家占比
3072
n_embd
77.6 GB
完整检查点
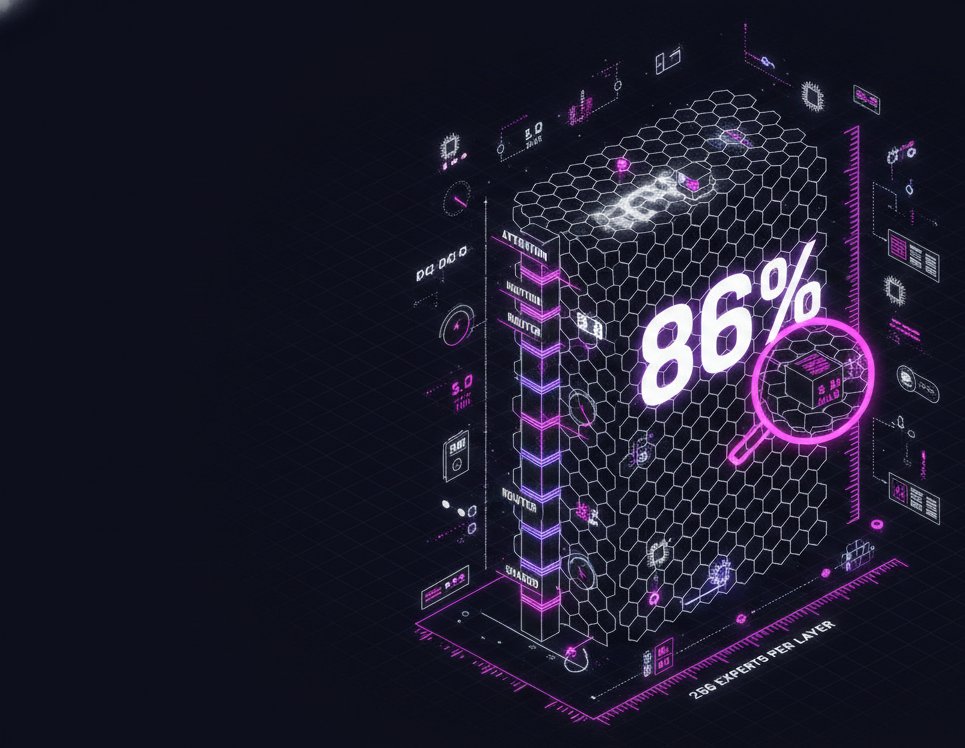
每层分为稠密路径——注意力 + KV、各类 norm、路由器(ffn_gate_inp)、共享专家——和以三个堆叠张量(ffn_up_exps、ffn_gate_exps、ffn_down_exps)存储的专家库:256 个独立 FFN。稠密路径只占字节的少数;专家库占模型的 86%。
布局的馈赠
专家是连续、块对齐的板块
- 专家索引是每个专家张量的最外层 ggml 维度(
ne[2])——专家 *e* 占据一整块连续、量化块对齐的原始量化字节板块。 - 这让按专家提取成为一次字节范围拷贝:
data[a:b],无反量化、无重打包——专家切片 mini-GGUF 制作成本低且逐位忠实。 - 每 token 每层只有路由器选中的 256 个中的 8 个专家点亮——解码时一层的专家流量只是对一个 hidden 向量的几次小矩阵乘。
意义
承载单位从 1.4 GB 降到 5.3 MB
在层颗粒下,节点能背的最小值约 1.4 GB——一旦应用、KV 和操作系统各占其份,大多数手机就够不着了。在专家颗粒下,单位是 5.3 MB,现实的贡献是 8–64 个专家(42–340 MB)——任何现代设备都绰绰有余。专家彼此独立,所有权可以任意散布、自由再平衡。正是这项分析让专家级分片成为设计上的押注:权重出厂时就已打包成蜂群大小的单位——网络只需尊重这份包装。