Phase 0 — 引擎:推理引擎 的控制平面 linkcpp
推理引擎 自带能干的 RPC 数据平面,却没有控制平面。linkcpp 围绕贴近上游构建的二进制补上缺失的那一半——发现、规划、启动与网关。
Kvasir 运行的一切都从这里开始。linkcpp 是围绕 推理引擎 RPC 数据平面的源码可得控制平面(Business Source License):它用贴近上游构建的 ggml-rpc-server / llama-server 二进制在多张 GPU 和多台机器上运行大型 AI 模型。数据平面只带一小组补丁——除此之外,linkcpp 增加的一切都是编排。
缺口
没有控制平面的数据平面
推理引擎 已经能通过 RPC 把模型拆到多台机器——但总得有人发现 GPU、决定哪些层放哪里、以正确预算启动正确的 worker、检查每个节点说同一种协议,并暴露开发者真正能调用的 API。为一个集群手工做这些是苦差;为一个由陌生人设备组成的开放网络做这些则不可能。那个协调层就是 linkcpp。
架构
一个 hub、基于上游的 worker、标准网关
请求流——hub 负责编排,基于上游的二进制负责计算。
browser / SDK
  → hub :19000                      # FastAPI control plane (single Docker image)
  → GPU-less llama-server master    # per-controller, :8080+
  → ggml-rpc-server workers         # local slots, remote units, managed agents
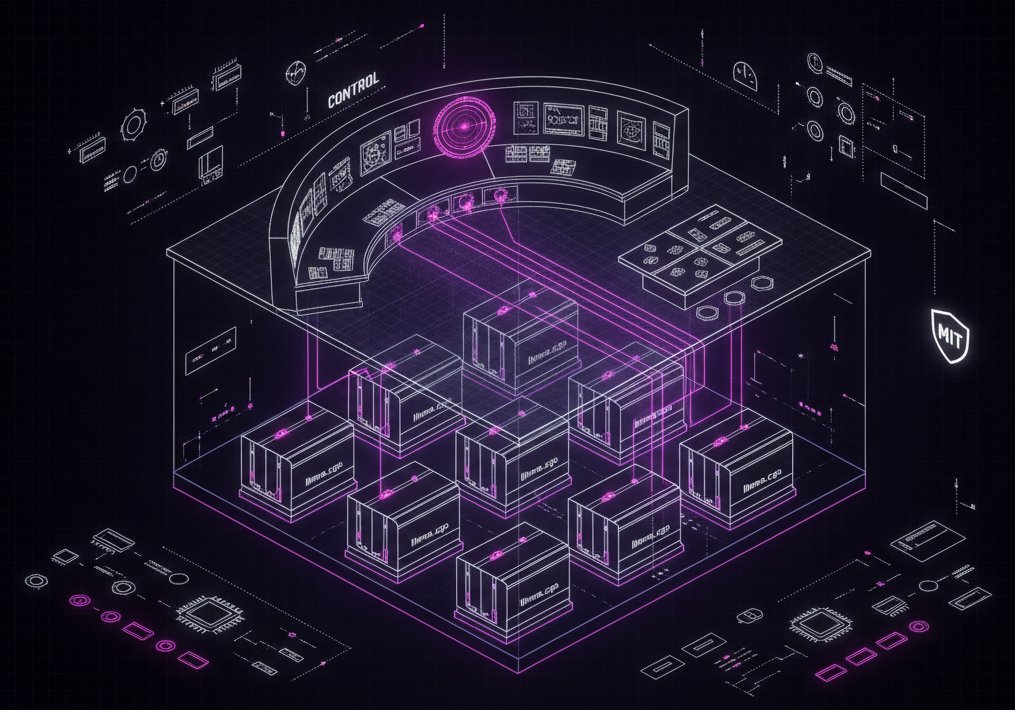
- 机器加入的三种方式:可编辑 VRAM/RAM/CPU 预算的固定本地节点槽;注册另一个 hub 并导入其节点的远程单元;以及受管节点代理——通过普通请求/响应 HTTP 加入的纯 worker 服务,刻意不用持久流,因而能在简单的 LAN/VPN 路由下存活。
- 兼容性闸门是一等概念:每个单元、节点和代理都上报协议/运行时包身份及后端细节。单元、运行时包、推理引擎 修订版与 RPC ABI 不匹配会在 bind/plan/load/infer 之前硬性阻断——后端差异(CUDA/Metal/Vulkan/CPU)作为能力记录,而非拒绝。
- 规划器读取 GGUF 元数据,产出按节点的连续层放置、
--tensor-split、KV 缓存/层/专家 VRAM 估算,以及可选的专家 FFN RAM 卸载。 - 网关:每个控制器都暴露 OpenAI 兼容(
/v1/chat/completions、/v1/models)与 Anthropic 兼容(/anthropic/v1/messages|models)端点,由同一个已加载模型支撑——现有客户端无需改动即可使用。
这种刻意的分离——源码可得控制平面之下、保持贴近上游的数据平面——是后来一切的地基:环运行时、层市场,直至专家分片蜂群,全都是同一算力之上的控制平面演化。