Phase 3 — 骨干专家 RAM 卸载 (M0)
把 MoE 专家 FFN 从 VRAM 改为从 CPU RAM 流式读取,一台 64 GB 协调器就装下 122B——无需图手术。
专家 FFN 不必住在 VRAM 里。从 CPU RAM 流式读取它们,让一台协调器装下专家超出其 VRAM 的模型——这是让弱节点得以加入大型 MoE 的地基。
规划器验证 · 真实 122B GGUF
122B 装进单台 64 GB 协调器
此前环只按 VRAM 放置权重,122B(77.6 GB)在 64 GB GCD 上 infeasible。启用专家卸载规则后,dry-run 返回 feasible:
feasible
122B 环方案
62.6
VRAM GiB (≤ 64)
14.2
RAM GiB (专家)
10
卸载的层数
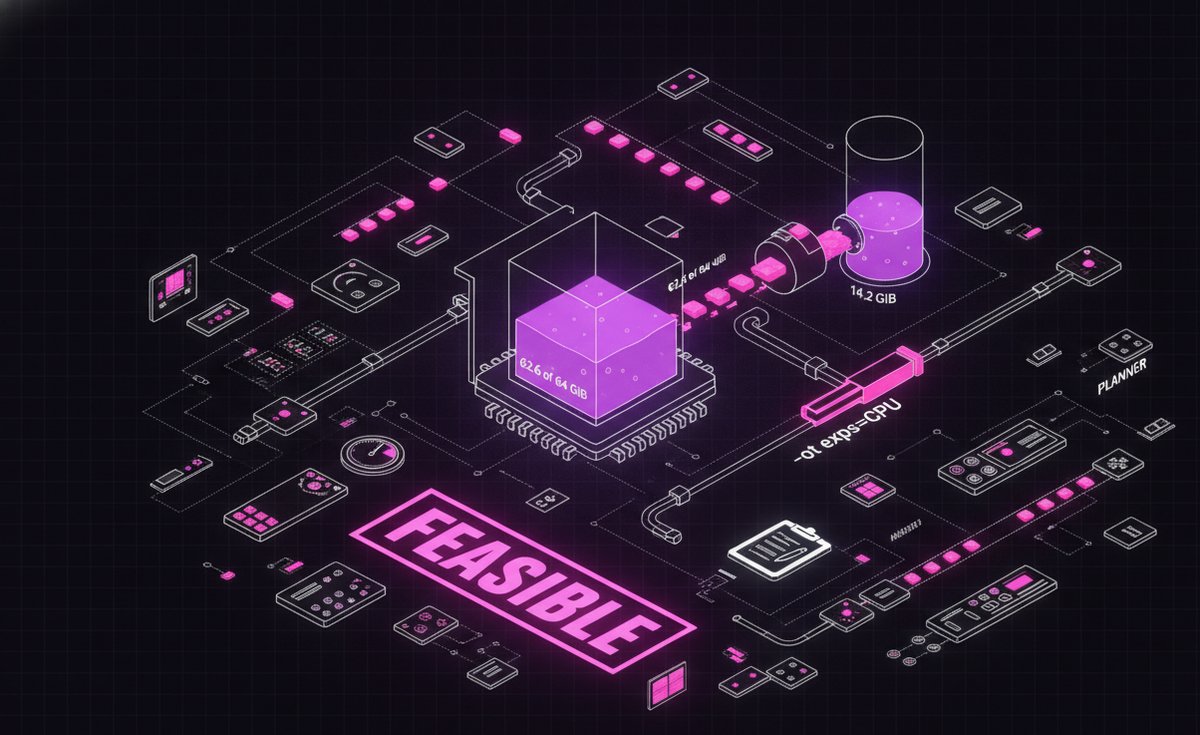
规划器输出——推理引擎 -ot 规则格式。
node 0  layers [0,48]  vram=62.6  ram=14.2  ot_rules=10
sample: blk\.38\.ffn_(up|down|gate)_(ch|)exps=CPU   # inference engine -ot format
接了什么线 · 纯 Python,无需重编 C++
把规划器的卸载规则送进真实加载
- planner — 每个 placement 中已生成
ot(逗号连接的-ot规则)。 - protocol.py — 新增
StageStartRequest.ot字段。 - runtime.py — 把 placement 的
ot转发进 stage 请求。 - stage_service.py — 协调器以
--override-tensor启动。 linkcpp-server把未知参数转发给原版 llama-server,-ot原样生效。
# stage_service.py — coordinator branch
if request.ot:
    command += ["--override-tensor", request.ot]
以 ot 协议往返测试加上确认协调器命令输出 --override-tensor 完成验证;hub 无回归地重新部署。当时剩下的:完整的 2 节点 77 GB 加载(带卸载的协调器 + 持有约 1.5 GB 单层窗口的手机),等待服务器可用。M0 的核心——让弱节点参与大 MoE 的骨干卸载——已在代码与规划器层面完结。