Phase 7 — 批量调度吞吐 (M4)
蜂群是吞吐织物而非延迟游戏:把调度调用打包成批,把每请求开销按 token 摊销 77 倍。
实测 · ROCm,专家 FFN,n_used = 8
批越大,每 worker 的 tok/s 越高
| 批量 | 每 worker tok/s |
|---|---|
| 1 | 688 |
| 16 | 4,255 |
| 64 | 8,130 |
| 256 | 30,666 |
| 512 | 53,067 |
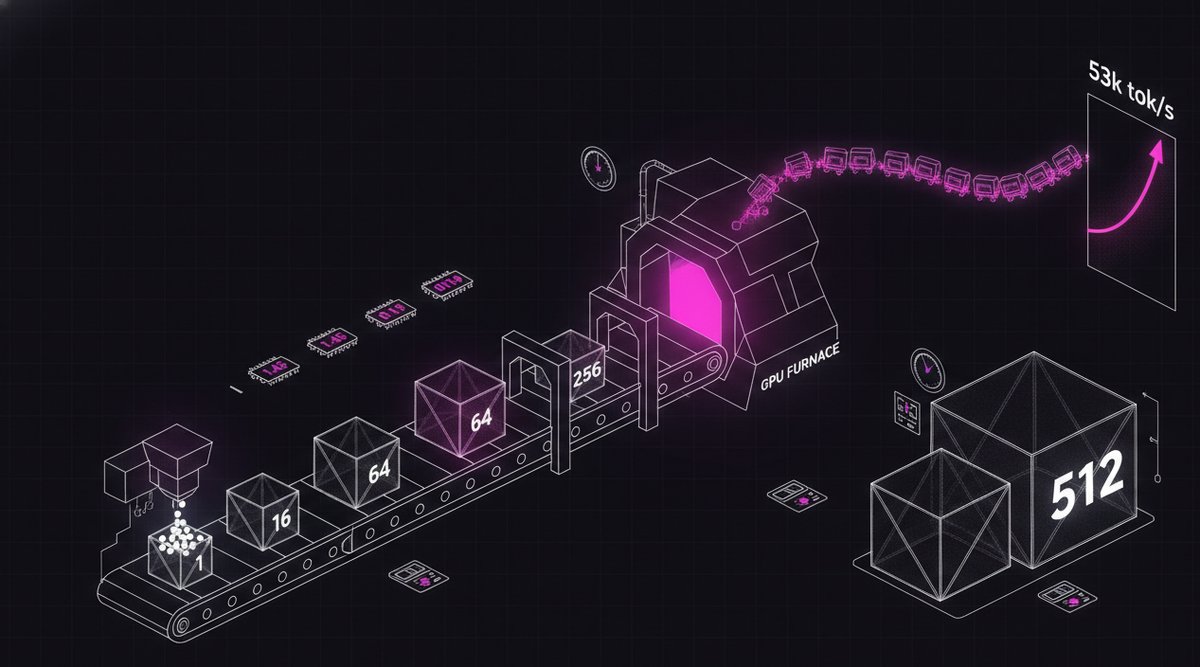
从批量 1 的 1.45 ms/tok 到批量 512 的 0.019 ms/tok——每 token 77 倍的提升。每次调用的时间几乎不变(1.45 → 9.6 ms),而批量增长了 512 倍——GPU 在固定开销之后几乎免费地处理整批。这就是让专家并行变得实用的吞吐织物特性:批量调度摊销了每请求的 RTT 与开销。
完成
批量调度吞吐
- worker
--bench:批量 1…512 的 compute_dispatch 计时 → tok/s。 - 批量 512(ROCm)下每 worker 53k tok/s——批处理摊销了开销。
- hot-expert 缓存与多 worker 聚合扩展(副本路由)在此之上叠加。
随着 M4,整条 M0 → M4 流水线已在真实 122B 上演示完毕:骨干卸载 · 专家切片 · 验证过的 worker · 实时解码调度(argmax MATCH)· 分布式进程 · 覆盖市场 · 批量吞吐。